Fraktúr szöveg OCR-ezése: őrizze meg az eredetit a modernizálás előtt
Végezzen el egy kis, reprodukálható fraktúr OCR-kísérletet, hogy megkülönböztesse a felismerési hibákat a hosszú s normalizálásától, mielőtt régi könyvet keresne vagy fordítana.
Nyomtatott fraktúr szöveg OCR-ezéséhez válasszon olyan modellt, amely támogatja az írásmódot, teszteljen egy rövid szövegrészletet az oldalhoz viszonyítva, és döntse el, hogy az átirat megtartsa-e a hosszú s-t ( ſ), vagy normalizálja skarakterre. Tartsa külön az ellenőrzött forrásátiratot bármilyen modernizálástól vagy fordítástól. Az ismerősebbnek tűnő szó nem feltétlenül jelenti a nyomtatott szöveg hűségesebb olvasatát.
Két rövid, szintetikus német szövegrészletet teszteltünk fraktúr betűtípussal és egy modern betűtípusú kontrollal. Még ezeken a tiszta képeken is a fraktúr modell a(z) iſt szót ift alakra módosította az egyik részletben, a másikban pedig if formára. A hasznos tanulság nem egy rangsor volt a győztes eszközről, hanem annak demonstrálása, hogy a karakterek felismerése, az átírási konvenció kiválasztása és a nyelv modernizálása három teljesen különálló feladat.
Ez az útmutató nyomtatott oldalakra vonatkozik. Nem hoz létre munkafolyamatot kézzel írott Kurrent vagy Sütterlin íráshoz, sérült kéziratokhoz vagy egy teljes történelmi gyűjteményhez.
Döntse el, mi számít helyesnek, mielőtt futtatná az OCR-t
Az eszközök összehasonlítása előtt fogalmazzon meg egy egymondatos átírási szabályt. Például: „Megtartom a forrás helyesírását és a hosszú s-t; megjelölöm a nem ellenőrizhető szavakat.” Különben előfordulhat, hogy egy szándékos normalizálást hibának tekint – vagy elfogad egy nem kívánt átírást csak azért, mert gördülékenynek tűnik.
Az OCR-D kézzelfogható példát nyújt erre a különbségtételre. A Level 1 szintű irányelvei a hosszú s-t és a kerek s-t egyaránt s; Levels 2 and 3 szintek megkülönböztetik őket. Ezek csupán átírási konvenciók, nem pedig utasítások arra, hogy minden régi helyesírást modern megfelelőjére cseréljünk. Tekintse meg a hivatalos Level 1 s szabályokat és Level 2/3 s szabályokat.
Személyes olvasási projekt esetén tartsa külön ezeket a kimeneteket:
| Kimenet | Példa a saját készítésű oktatószövegünkből | Mire való |
|---|---|---|
| Forrásközpontú átirat | Die rothe Blume ſteht hier. | A felismert karakterek összevetése az eredeti képpel |
| Hosszú s betűket normalizáló változat | Die rothe Blume steht hier. | Keresés vagy olvasás a hosszú s megkülönböztetése nélkül |
| Modernizált változat | Die rote Blume steht hier. | Külön szerkesztett változat helyesírási módosításokkal |
A második sor csupán az ſ betűt cseréli sbetűre; nem vezeti be az összes OCR-D Level 1 szabályt. A harmadik sor a forrás helyesírását is módosítja. Egyik származtatott változat sem válthatja fel észrevétlenül a forrásközpontú átiratot.
Különösen fontos: ne cserélje le globálisan az f betűt sbetűre. A hibás OCR-kimenetünk tartalmazza a(z) iftalakot, de a forrásban valódi f is előfordulhat. A szót a kép alapján javítsa ki, ne egy általános behelyettesítési szabály mentén.
Mi történt a nyolchívásos kísérletünkben
A 2026. szeptember 11-i kísérletünkben két eredeti, háromsoros oktatási szövegrészletet jelenítettünk meg a(z) UnifrakturMaguntia és a(z) Noto Sansbetűtípussal. Mindkét képet két rögzített Tesseract-modellel ismertettük fel: a(z) tessdata_best fraktúr írásmódhoz készült modellel és az angol modellel. Az angol konfiguráció kontrasztként szolgál, nem modern német viszonyítási alapként.
Mind a nyolc hívás a Tesseract 5.5.3-at használta LSTM módban (--oem 1), egyetlen szövegblokként (--psm 6), 300 dpi felbontás mellett. Nem módosítottuk a beállításokat, nem zártunk ki eredményeket, és nem futtattuk újra a felismerést az eredeti kísérleten belül. Ugyanennek a nyolc képnek a szeptember 12-i, csomagolt újrajátszása bájtra pontosan reprodukálta a mentett kimenetet.
A képek valós betűformálást kaptak az Apple CoreText segítségével, engedélyezett ligatúrákkal, nem pedig formázatlan karakterdobozokként lettek megrajzolva. 64 képpontos szöveget használnak egy 2200 × 460-as fehér vásznon. A képek, a glifaszám-ellenőrzések, a betűtípus-licencek, a modell-hashek és a nyers kimenetek elérhetők a kísérleti csomag útmutatójában.
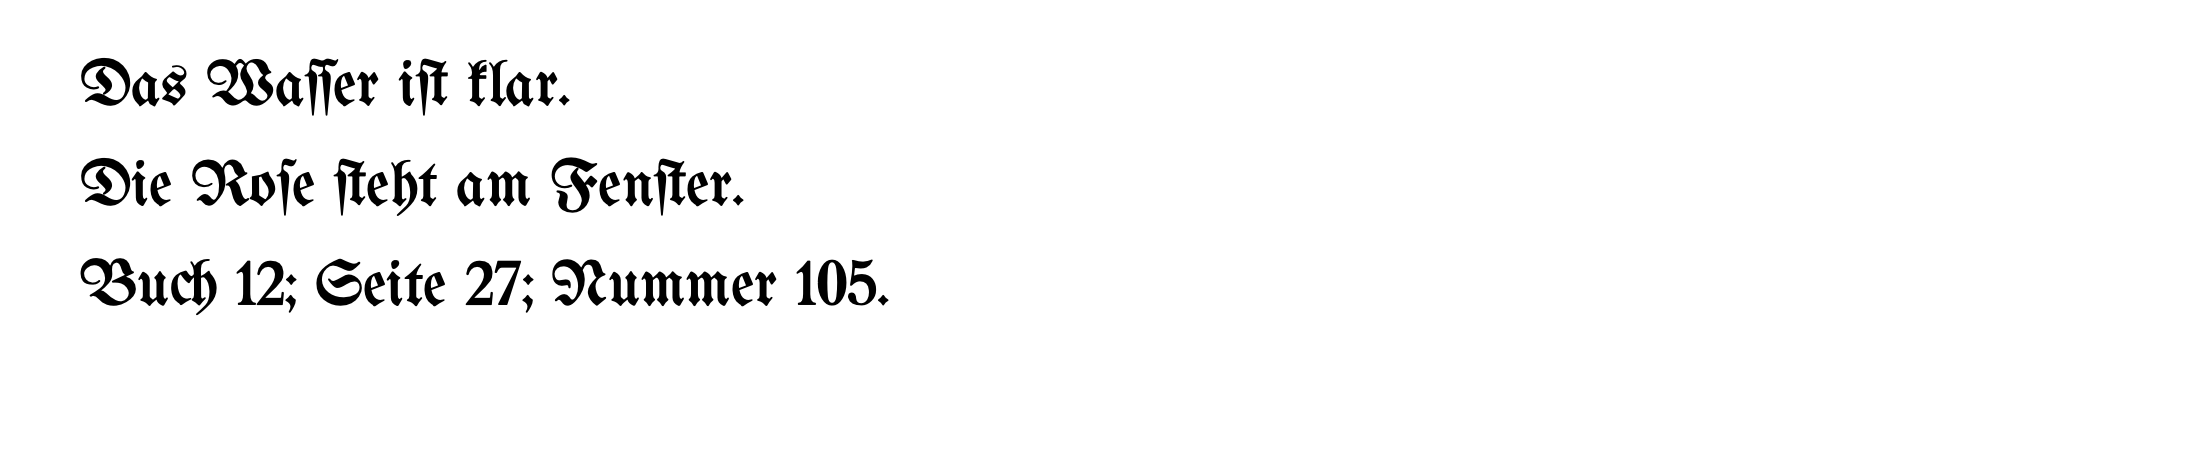
A specializált modell is javításra szorult
Az első forrássor a következő volt:
Das Waſſer iſt klar.
A fraktúr betűtípusú képen a Fraktur modell ezt adta vissza:
Das Waſſer ift klar.
A sor nagy része megmaradt, de a(z) ſ a(z) iſt szóban flett. A második részletben a(z) Das Thal iſt weit. erre módosult: Das Thal if weit.: a felismerés egy karaktert megváltoztatott, egy másikat pedig elhagyott. Az, hogy a kimenet hihető német szövegnek tűnik, még nem helyettesíti az eredeti ellenőrzését.
Egy másik hiba jelentkezett a modern betűtípusos kontrollnál. A Fraktur modell megtartotta a szavakat az első részletben, de a két pontosvesszőt a(z) Buch 12; Seite 27; Nummer 105. részben kettőspontra cserélte. Ha csak a hosszú s betűt ellenőrizzük, ezek az írásjel-változások észrevétlenek maradtak volna.
A cél módosítja az eredményt
Minden nyers kimenetet két, a felismerés előtt rögzített célértékhez viszonyítva értékeltünk: a pontos forrásszöveghez, valamint a forráshoz kizárólag ſ → s. Mindkét összehasonlítás NFC-re normalizálja az Unicode-ot, és összevonja a szóközöket; a kis- és nagybetűket, valamint az írásjeleket megtartják. Az értékelés előtt nem alakítjuk át a nyers kimenetet kisbetűssé.
Az alábbi számok karakterszintű szerkesztési távolságok – beszúrások, törlések és helyettesítések –, nem pedig pontossági százalékok.
| Részlet | Renderelt betűtípus | OCR-modell | Szerkesztések a pontos forráshoz képest | Szerkesztések a csak hosszú s-re normalizált célhoz képest |
|---|---|---|---|---|
| Hosszú s és számok | Fraktúr | Fraktúr | 1 | 6 |
| Hosszú s és számok | Fraktúr | Angol | 8 | 8 |
| Hosszú s és számok | Noto Sans | Fraktúr | 2 | 8 |
| Hosszú s és számok | Noto Sans | Angol | 7 | 7 |
| Korhű jellegű helyesírás | Fraktúr | Fraktúr | 2 | 4 |
| Korhű jellegű helyesírás | Fraktúr | Angol | 7 | 7 |
| Korhű jellegű helyesírás | Noto Sans | Fraktúr | 0 | 3 |
| Korhű jellegű helyesírás | Noto Sans | Angol | 4 | 4 |
A nullás érték az adott sorban pontos egyezést jelent az adott rövid bemenetre. Semmit sem árul el egy valódi könyv következő oldaláról. Ezzel szemben az a modell, amely helyesen megőrzi a(z) ſ formát, további eltéréseket kap, ha egy olyan célszöveghez hasonlítjuk, amely a(z) sformát követeli meg. Ezek a különbségek szabályrendszerbeli eltérést jeleznek, nem feltétlenül felismerési hibát.
Tekintse meg az összes eredeti kimenetet és pontszámot, a rögzített forrásszövegeket és értékelési szabályrendszert, vagy az ellenőrző szkriptet. A csomag SHA-256 hash-eket rögzít, így a modell, a kép és a kimenet minden egyes eredményhez hozzárendelhető.
Amiről ez a kísérlet nem tud felvilágosítást adni
Ez két tiszta, nagy betűméretű, mesterségesen generált szövegrészlet volt – nem pedig egy régi kiadás szkennelt változata. Nem teszteltünk kifakult tintát, apró betűs szedést, margókat, hasábokat, sérült papírt, kézírást vagy független emberi átiratokat sem. Emellett nem vizsgáltunk modern német modellt, kereskedelmi OCR-eszközöket, sem pedig a BookTranslator OCR- vagy fordítási kimenetét.
Kezelje ezeket a példákat olyan szempontokként, amelyek miatt érdemes átvizsgálnia a saját anyagait, nem pedig a teljes könyvre vetített hibaarányok becsléseként. Mi sem választanánk OCR-szolgáltatást egy történeti gyűjteményhez kizárólag e táblázat alapján.
Futtasson célzott tesztet a ténylegesen szükséges oldalakon
Ha helyileg használja a Tesseractot, a kimenetek összehasonlítása előtt jegyezze fel a motor verzióját és a pontos modellfájlt. A modell neve önmagában nem azonosítja a letöltött fájlt. A származási nyilvántartásunk hivatkozza a rögzített nyilvános modell- és betűtípus-forrásokat; a nagyméretű modellfájlok nincsenek a cikkhez csatolva.
Az egyetlen blokkból álló mintaképünkesetében, a Fraktur írásrendszer-modellt helyileg models/Fraktur.traineddatanéven elmentve, a parancs a következő volt:
tesseract samples/long-s-fraktur.png stdout --tessdata-dir ./models -l Fraktur --oem 1 --psm 6 --dpi 300
A Tesseract parancssori dokumentációja részletesen ismerteti az LSTM módot és a PSM 6 által feltételezett egységes, önálló szövegblokkot. Ez a feltételezés illik a háromsoros mintaképünkre, de nem jelenti azt, hogy minden többhasábos könyvoldalt PSM 6-tal kellene feldolgozni.
A saját könyvénél érdemes egy olyan résszel kezdeni, amelyet magabiztosan át tud írni, valamint egy nehezebb, a feldolgozandó anyagra jellemző oldallal. Legyen benne egy név vagy ismeretlen kifejezés, egy szám, valamint betűtípus-váltás is. Ha a könyvben váltakoznak az írásrendszerek vagy nyelvek, használja a különálló többnyelvű PDF OCR útmutatót , ahelyett hogy feltételezné: egyetlen tiszta fraktúr bekezdés az egész dokumentumra érvényes.
Hagyja változatlanul a szkennelt képet. Mentse el a nyers OCR-eredményt a javításoktól elkülönítve, és rögzítse az oldal- vagy képazonosítót minden ellenőrzött szövegrészletnél. Ha a kimenet olvashatatlan, vizsgálja felül az oldalképet és a szegmentálást, mielőtt a feladatot több száz oldalra kiterjesztené.
Javítsa az átiratot anélkül, hogy hiányzó szavakat találna ki
Használjon egy egyszerű, négyoszlopos javítási naplót: forrás helye, nyers OCR, ellenőrzött szövegváltozat és indoklás. Az indoklásban érdemes különválasztani a látható karakterhibát a szerkesztői átalakítástól.
| Megfigyelés | Hasznos lépés | Kerülendő lépés |
|---|---|---|
A képen egyértelműen a(z) iſtlátható; az OCR viszont a következőt adta: ift | Javítsa ezt az előfordulást a kép alapján | Az összes f cseréje a dokumentumban |
Az OCR megőrzi a(z) rothealakot, de az olvasáshoz a(z) rote alakra van szüksége | Tartsa meg a forrásformát, és hozzon létre egy címkével ellátott, korszerűsített változatot | A korszerűsítést OCR-javításként kezelni |
| Egy szám vagy írásjel eltér | Ellenőrizze az adott helyet még akkor is, ha a környező mondat folyamatosnak tűnik | Csak a szokatlan betűformák áttekintése |
| A kép valóban olvashatatlan | A bizonytalanság jelölése a munkapéldányban, megőrizve a képre mutató hivatkozást | Egy valószínűsíthető generált szó elfogadása helyreállított bizonyítékként |
Ha a letöltött PDF-ben a szöveg már kijelölhető, a beillesztett szöveget vesse össze a képpel, mielőtt mindent elölről kezdene. A PDF másolás-beillesztési hibafeltárás bemutatja, miért nézhet ki helyesen egy látható oldal, miközben a rejtett vagy leképezett szövege hibás. Ez a probléma eltér a megfelelő fraktúrfelismerő modell kiválasztásától.
Álljon meg a megbízható forrásszöveg előállítása után, ha a feladat mindössze keresésből, idézetek ellenőrzéséből vagy a német szöveg elolvasásából állt. A fordítás nem kötelező tisztítási lépés.
Csak akkor fordítson, ha a nyelv továbbra is akadályt jelent
Azoknak az olvasóknak, akiknek egy másik nyelvre van szükségük, az ellenőrzött forrás jelenti azt a pontot, ahol a fordítás valóban hasznossá válik. Tartsa jól megkülönböztethetően a szkennelt képet, az átnézett átiratot és a fordítást, hogy egy vitatott részletről egyértelműen megállapítható legyen, a felismerésből vagy a fordításból ered-e. A szkennelt PDF-ek fordítási munkafolyamata részletesen bemutatja a folyamat további lépéseit.
Ha a BookTranslator PDF-fordítójátválasztja, a teljes eredményre való hagyatkozás előtt érdemes a saját dokumentum egy reprezentatív részletét ellenőrizni. Kísérletünk nem hitelesíti a BookTranslator történelmi fraktúr szövegekre vonatkozó teljesítményét. Az OCR mód egy tiszta dokumentumot épít fel újra, ami módosíthatja az eredeti oldalelrendezést, a betűtípusokat és a betűméreteket; ne kezelje ezt a kimenetet hasonmásként, és ne feltételezze, hogy az eredeti oldalszámozási hivatkozások változatlanok maradnak.
A gyakorlati sorrend egyszerű: állapítsa meg a forrás olvasatát, jelöljön minden normalizálást, majd fordítson, ha szükséges. A gördülékeny szövegezésnek a folyamat legvégén van a helye – nem pedig a bizonyítékok helyett a legelején.
Kapcsolódó bejegyzések