โหมด OCR
เปลี่ยน PDF ใด ๆ — แม้แต่หน้าสแกน — ให้กลายเป็นเอกสารสองภาษาที่ค้นหาและแก้ไขได้
โหมด OCR อ่าน PDF ที่สแกนมาและ PDF ที่มีรูปภาพจำนวนมาก เก็บเนื้อหา เช่น ข้อความ รูปภาพ และตาราง จากนั้นสร้างเอกสารสะอาดขึ้นใหม่ โดยอาจไม่คงเค้าโครงหน้าเดิม ฟอนต์ หรือขนาดฟอนต์ไว้
ทำไมต้องใช้โหมด OCR?
PDF สแกน → ข้อความแก้ไขได้
ระบบ OCR ขั้นสูงสามารถดึงข้อความจากหน้าสแกนและรูปภาพ สร้าง PDF ที่ค้นหาและแก้ไขได้เต็มรูปแบบ — ไม่ต้องคัดลอกวางจากรูปภาพอีกต่อไป
การอ่านสองภาษาที่สะอาดตา
ผลลัพธ์จะถูกสร้างใหม่เพื่อให้อ่านง่าย แทนการจับคู่ดีไซน์เดิม จึงช่วยลดร่องรอยการซ้อนทับ การทับกัน และข้อความที่ผิดเพี้ยน
ทำงานได้ดีกว่ากับ PDF ที่ซับซ้อน
ใช้ โหมด OCR สำหรับหนังสือเรียน บทความวิชาการ ตาราง และหน้าที่มีรูปภาพจำนวนมาก เมื่อการเก็บเนื้อหาสำคัญกว่าการคงเค้าโครงเดิมอย่างแม่นยำ
ตัวเลือกภาษาเดียว
รับ PDF ที่มีเฉพาะการแปล โดยไม่มีข้อความต้นฉบับ เพื่อประสบการณ์การอ่านที่ราบรื่น — เหมาะสำหรับ e-reader หรือการพิมพ์
วิธีการทำงาน
อัปโหลด PDF ของคุณ
อัปโหลดหนังสือที่สแกน เอกสารวิชาการ หรือ PDF ที่มีรูปภาพจำนวนมาก เปิดสวิตช์โหมด OCR ก่อนทำการแปล
OCR & การแปลด้วย AI
ระบบของเราดึงข้อความโดยใช้ OCR ขั้นสูง แล้วแปลด้วย AI ล้ำสมัย พร้อมคงโครงสร้างเอกสารไว้
ดาวน์โหลด PDF สะอาด
รับ PDF ที่สร้างใหม่พร้อมข้อความที่ค้นหาและแก้ไขได้ เลือกแบบสองภาษา (ต้นฉบับ + การแปล) หรือภาษาเดียว (เฉพาะการแปล)
โหมดมาตรฐาน เทียบกับ โหมด OCR
| โหมดมาตรฐาน | โหมด OCR | |
|---|---|---|
| แนวทาง | วางการแปลซ้อนบน PDF ต้นฉบับ | ดึงเนื้อหาด้วย OCR แล้วสร้างเอกสารสะอาดขึ้นใหม่ |
| PDF สแกน | รองรับจำกัด | รองรับ OCR เต็มรูปแบบ — ข้อความสามารถค้นหาและแก้ไขได้ |
| คุณภาพข้อความ | อาจมีข้อความซ้อนทับหรือสิ่งแปลกปลอม | ข้อความสะอาด ไม่มีสิ่งแปลกปลอม |
| รูปแบบผลลัพธ์ | PDF ที่แปลภาษาเดียว | PDF แบบสองภาษา + PDF แบบภาษาเดียว |
| รูปแบบต้นฉบับ | คงรูปแบบเดิม เช่น ฟอนต์ สี ลายนํ้า | เก็บเนื้อหาไว้ แต่เค้าโครง ฟอนต์ และขนาดอาจเปลี่ยนแปลงได้ |
| เหมาะสำหรับ | PDF ที่เลือกข้อความได้ เอกสารแบรนด์ และเลย์เอาต์เรียบง่าย | หนังสือที่สแกน หนังสือเรียน งานวิชาการ |
ก่อนและหลัง
ดูว่าโหมด OCR เปลี่ยนหน้า PDF ที่อ่านยากให้เป็นผลลัพธ์การแปลที่สะอาดได้อย่างไร
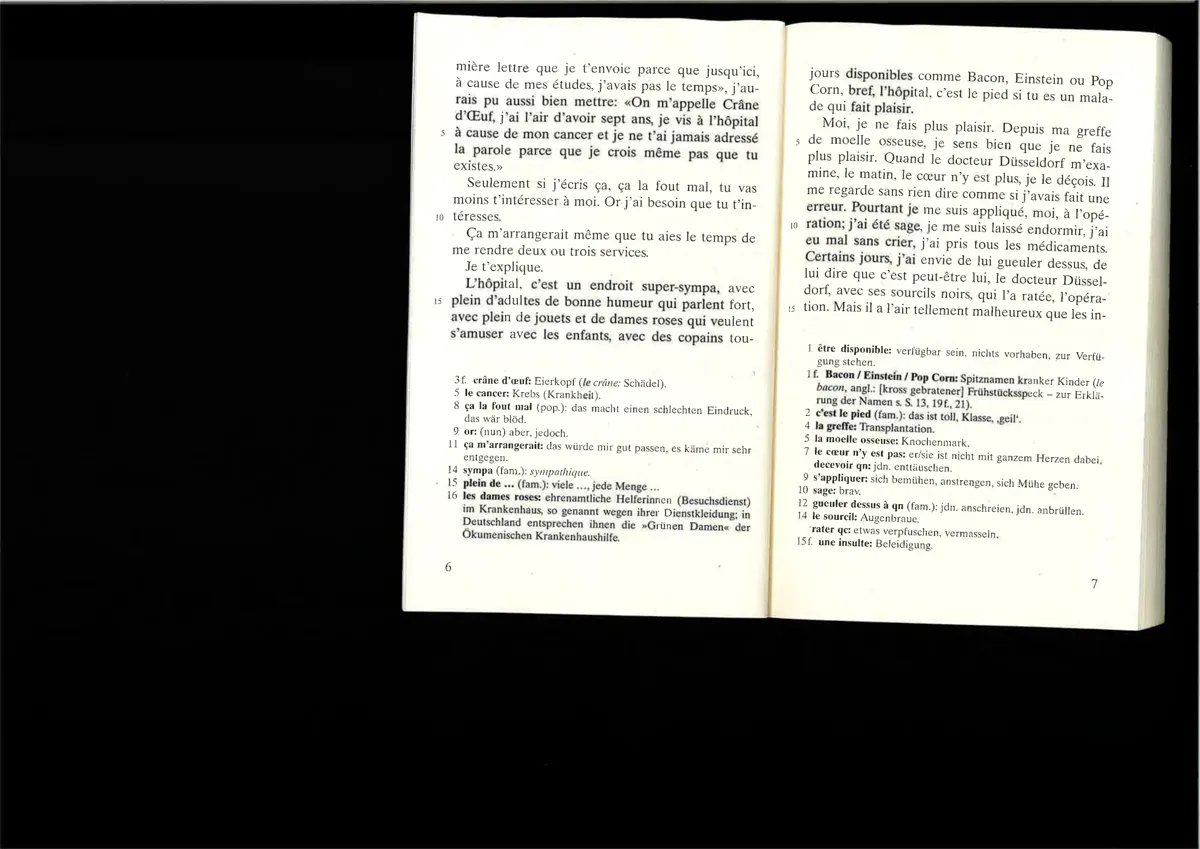
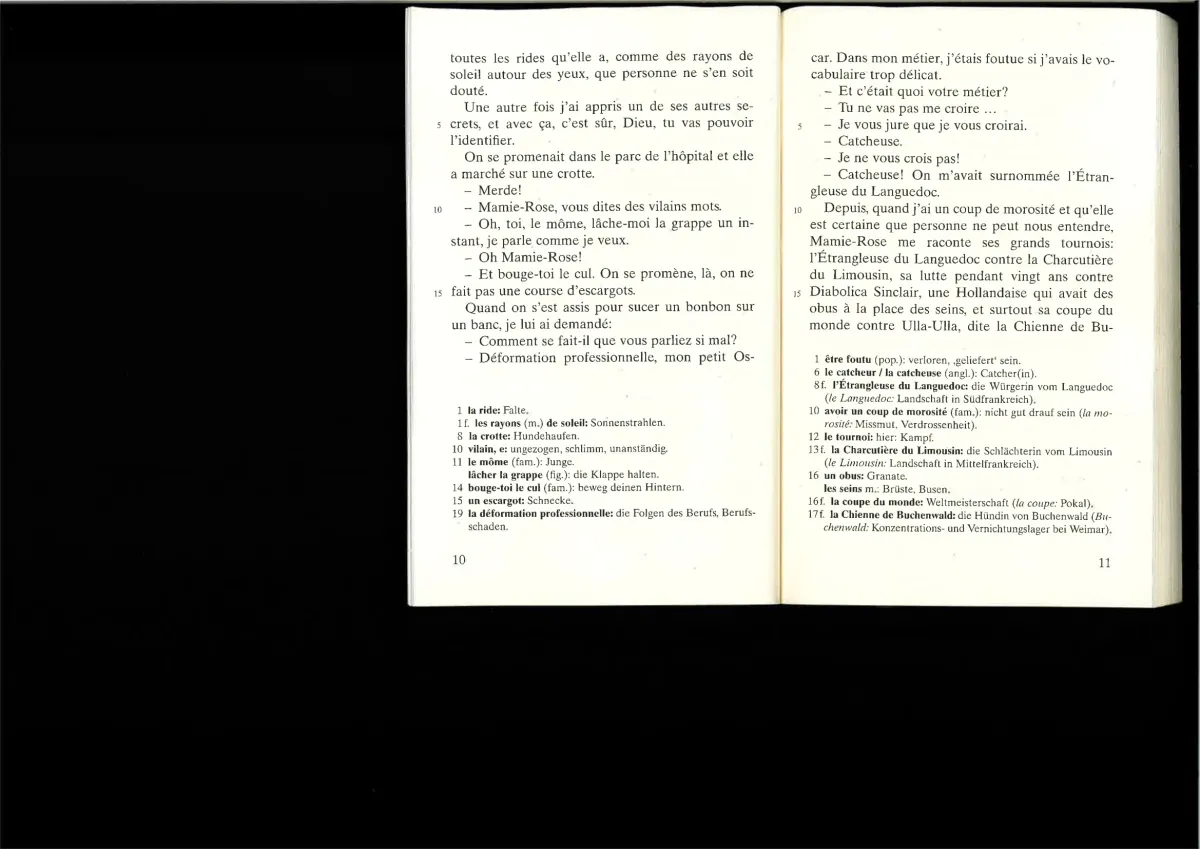
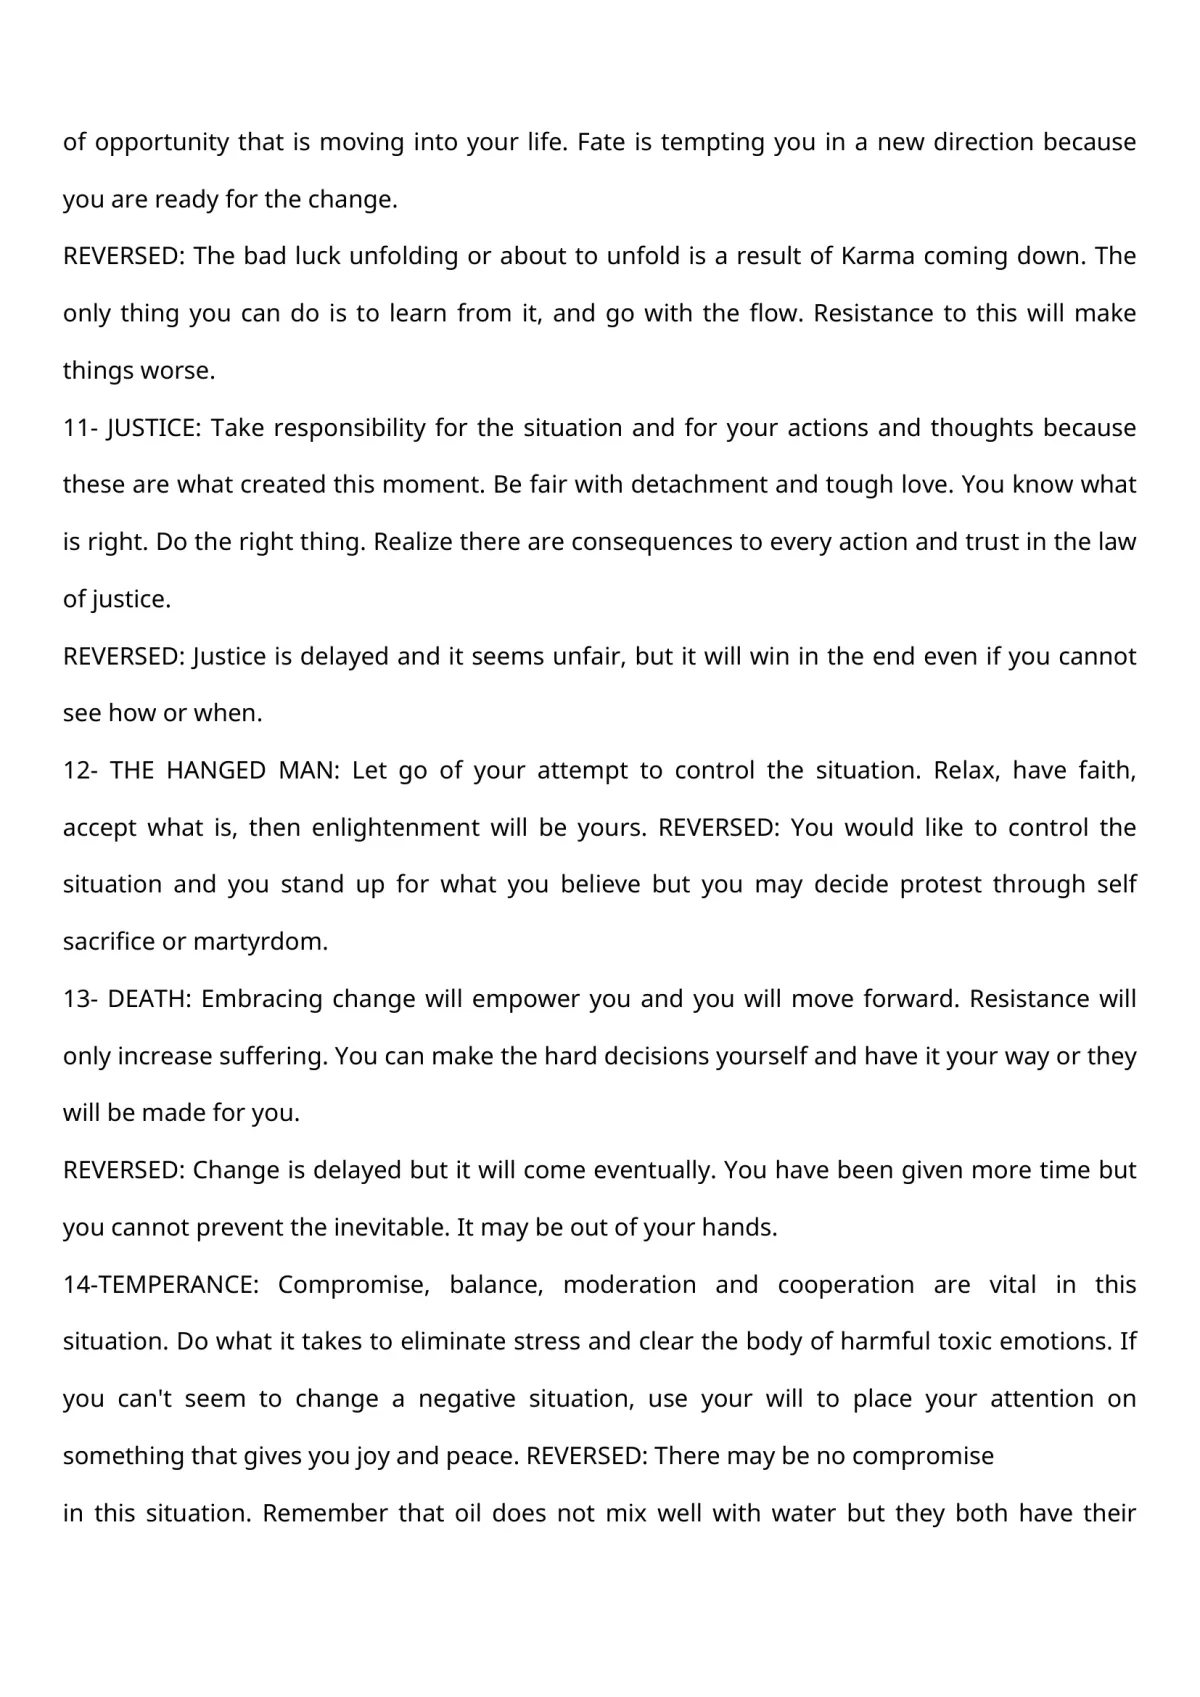
หน้าที่สแกน (ภาพเท่านั้น ไม่สามารถเลือกข้อความได้)
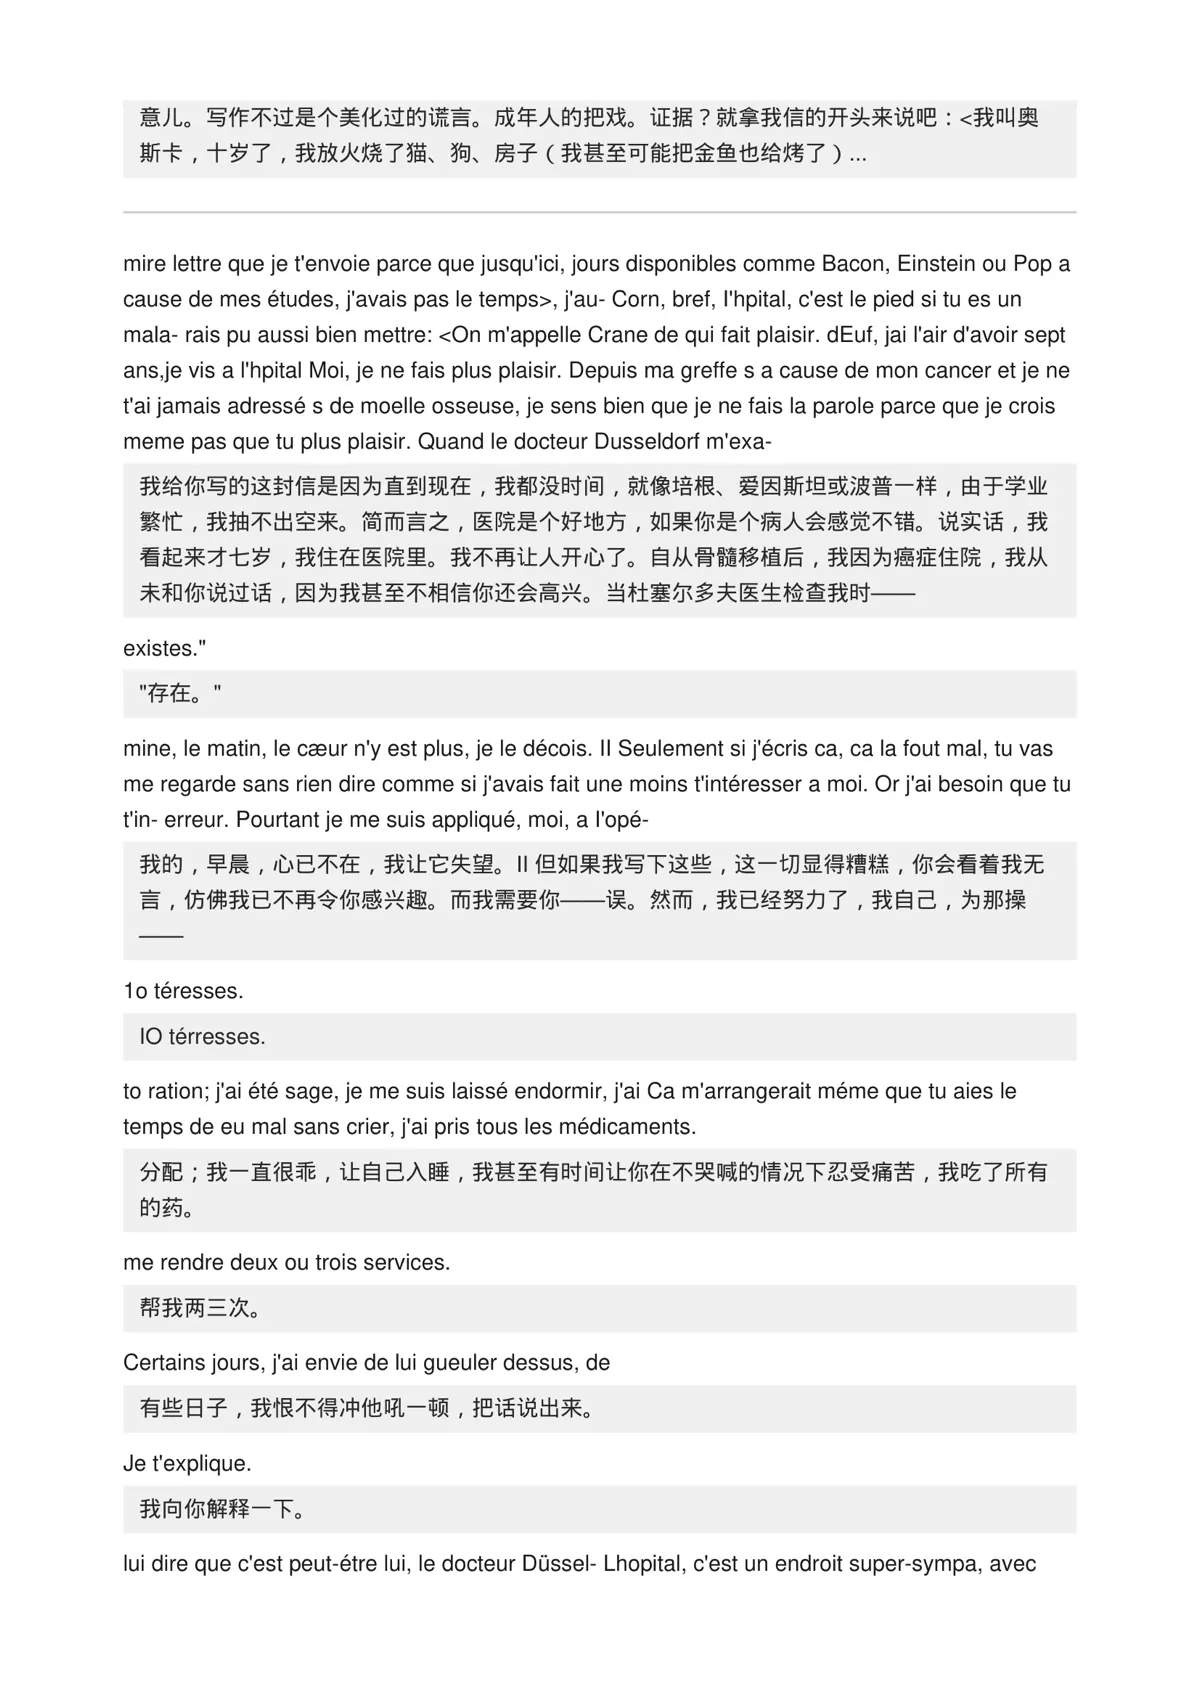
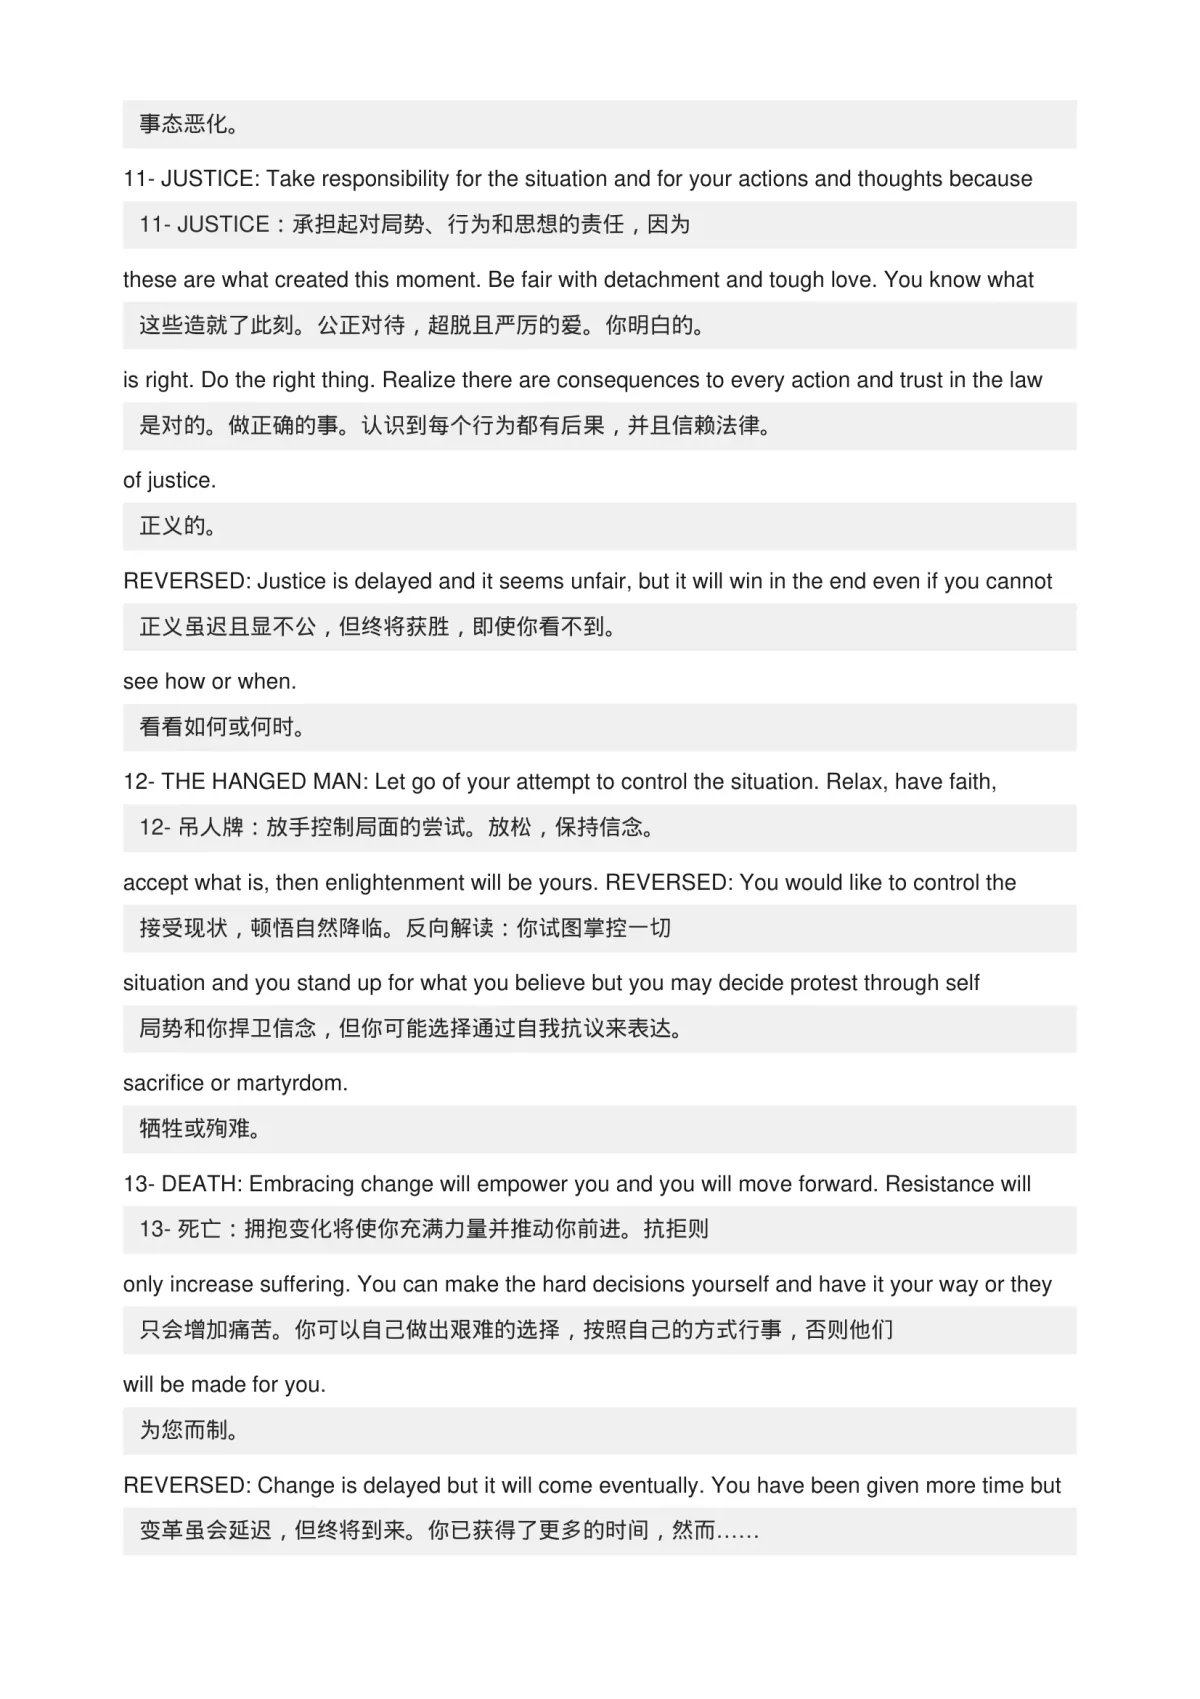
PDF แบบสองภาษาที่สะอาดและแก้ไขได้
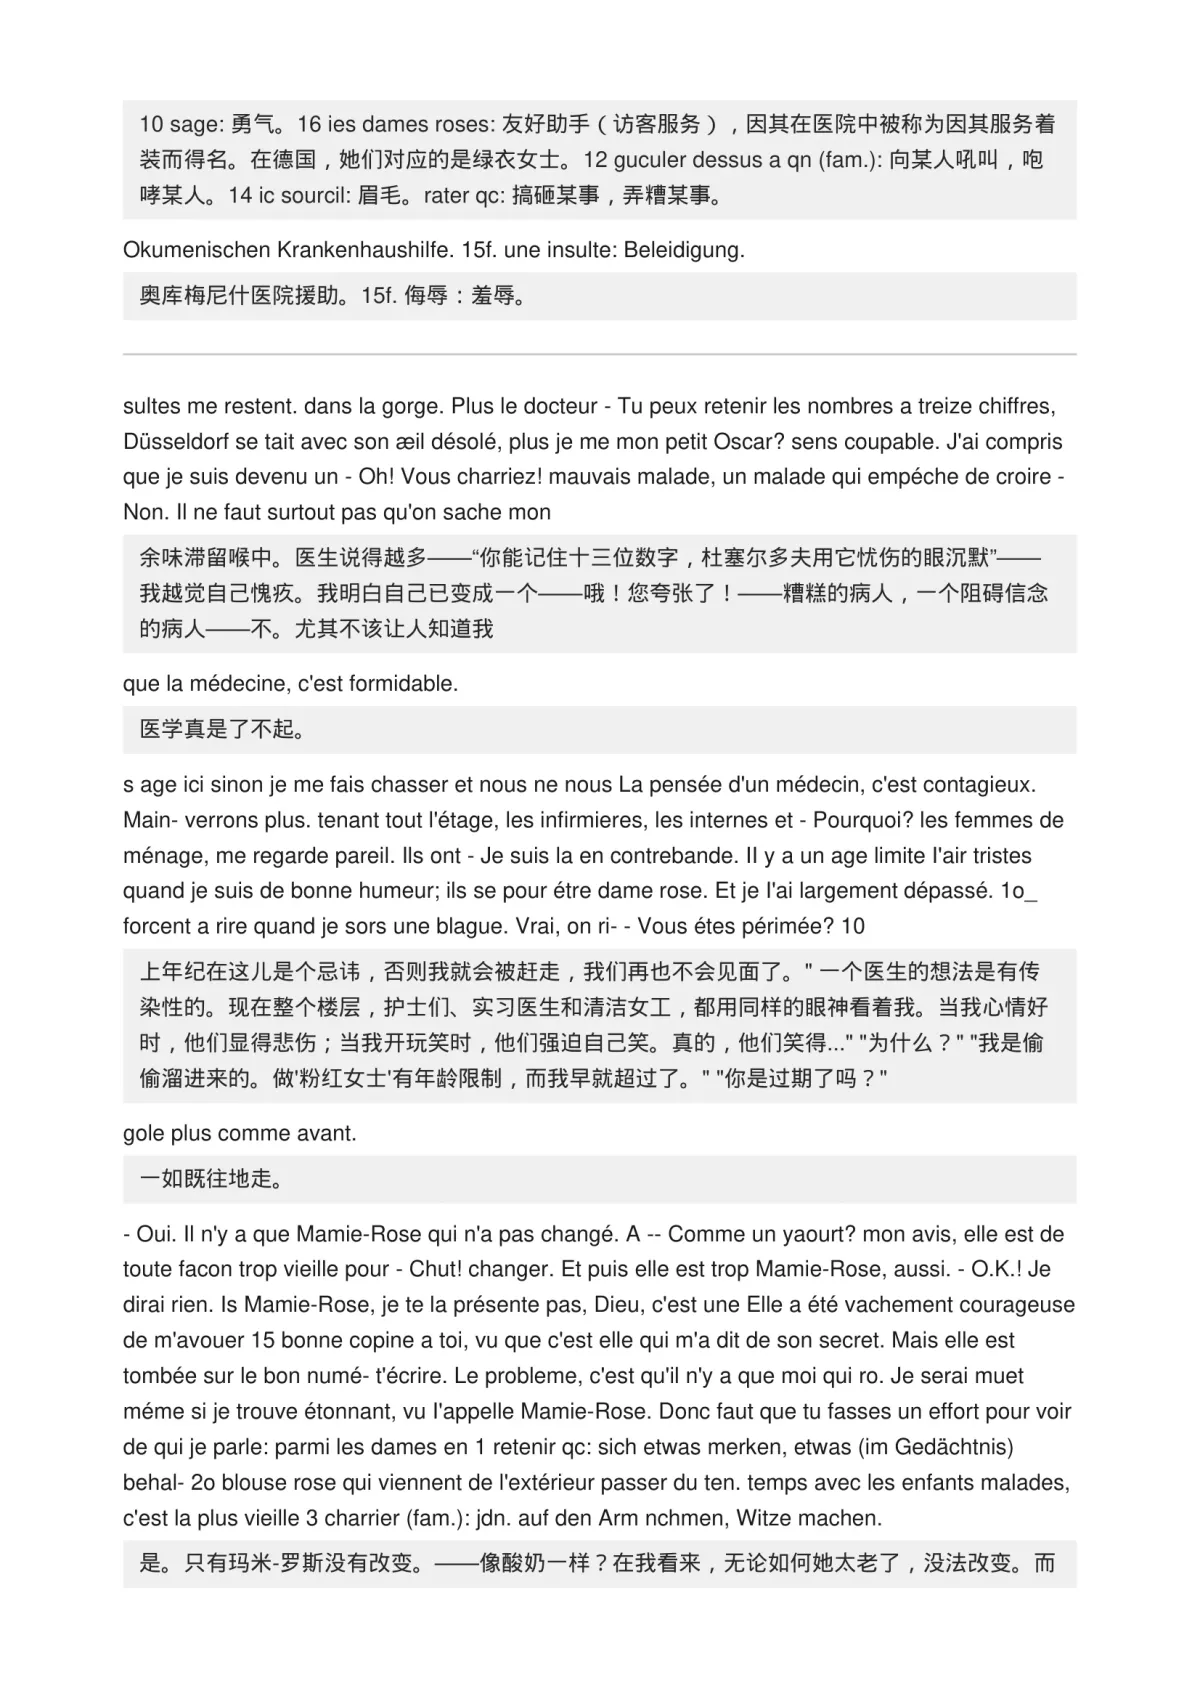
ข้อความซ้อนทับและสิ่งแปลกปลอม
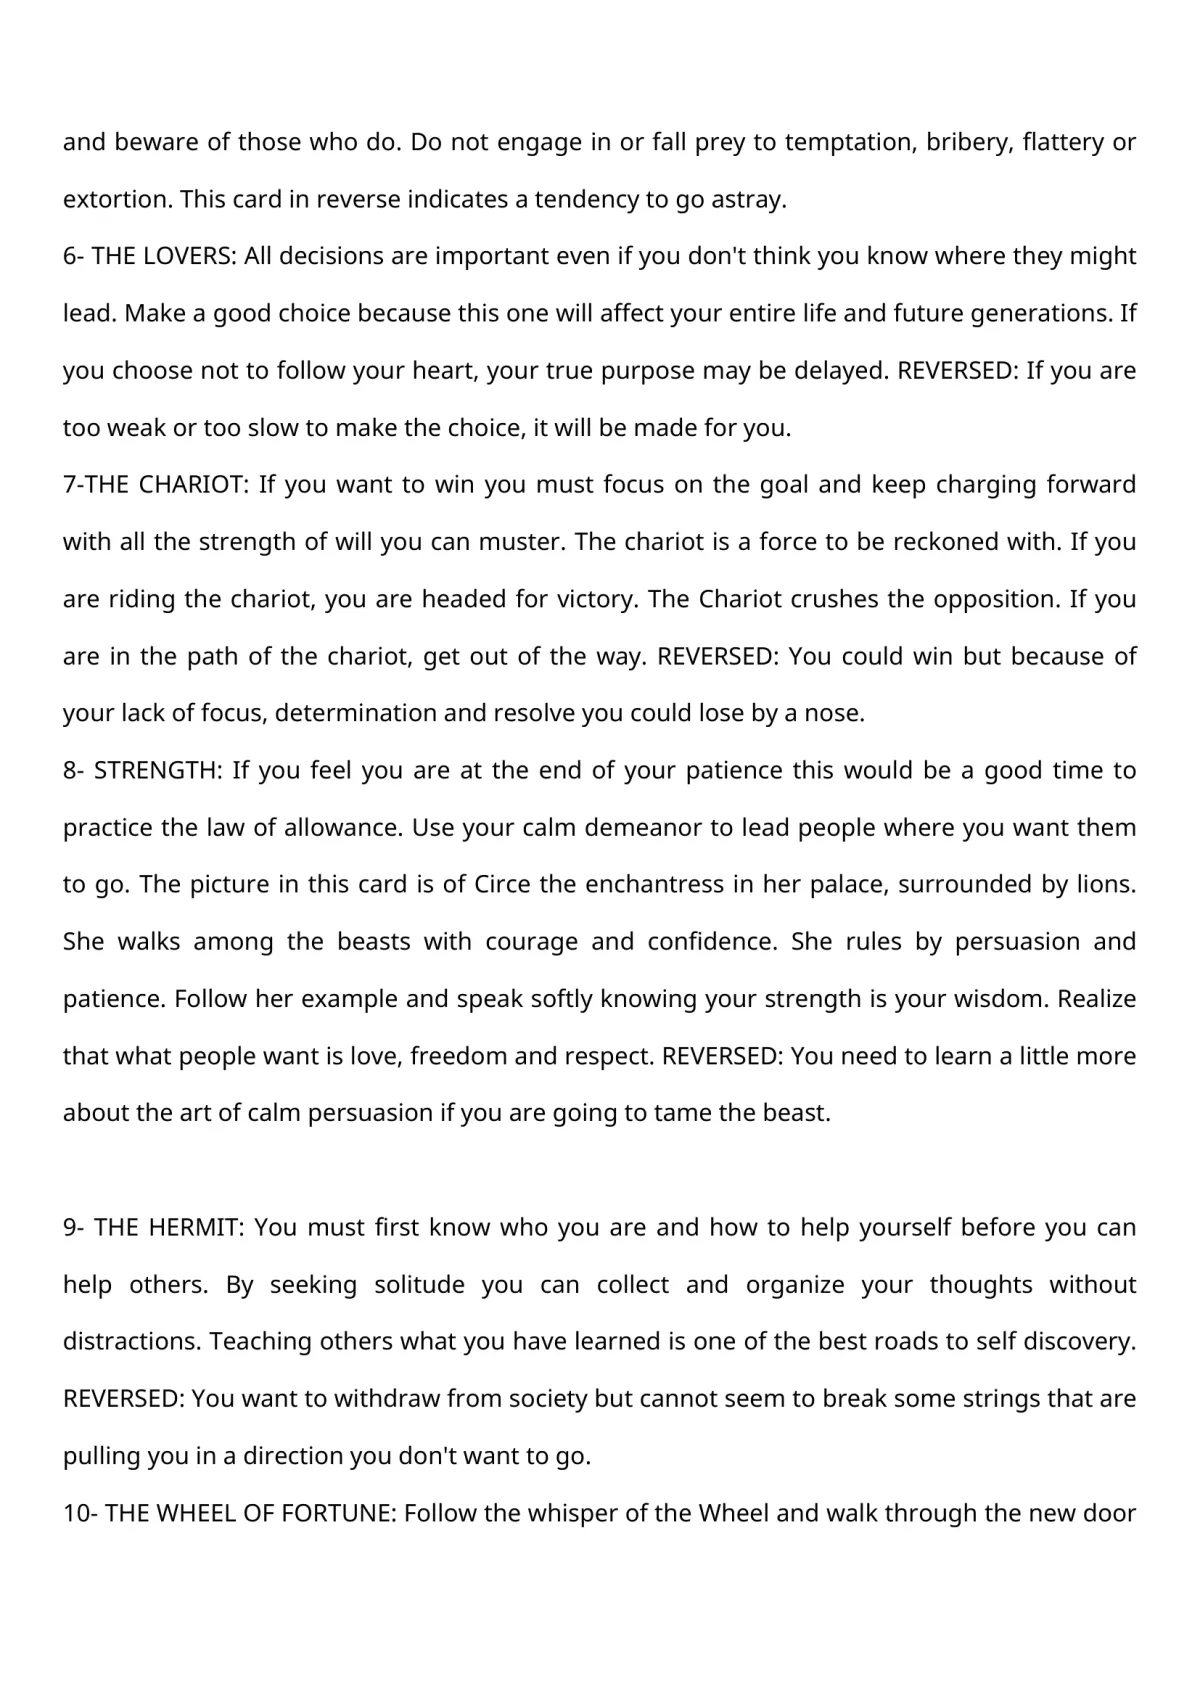
แปลภาษาได้อย่างสะอาดและอ่านง่าย
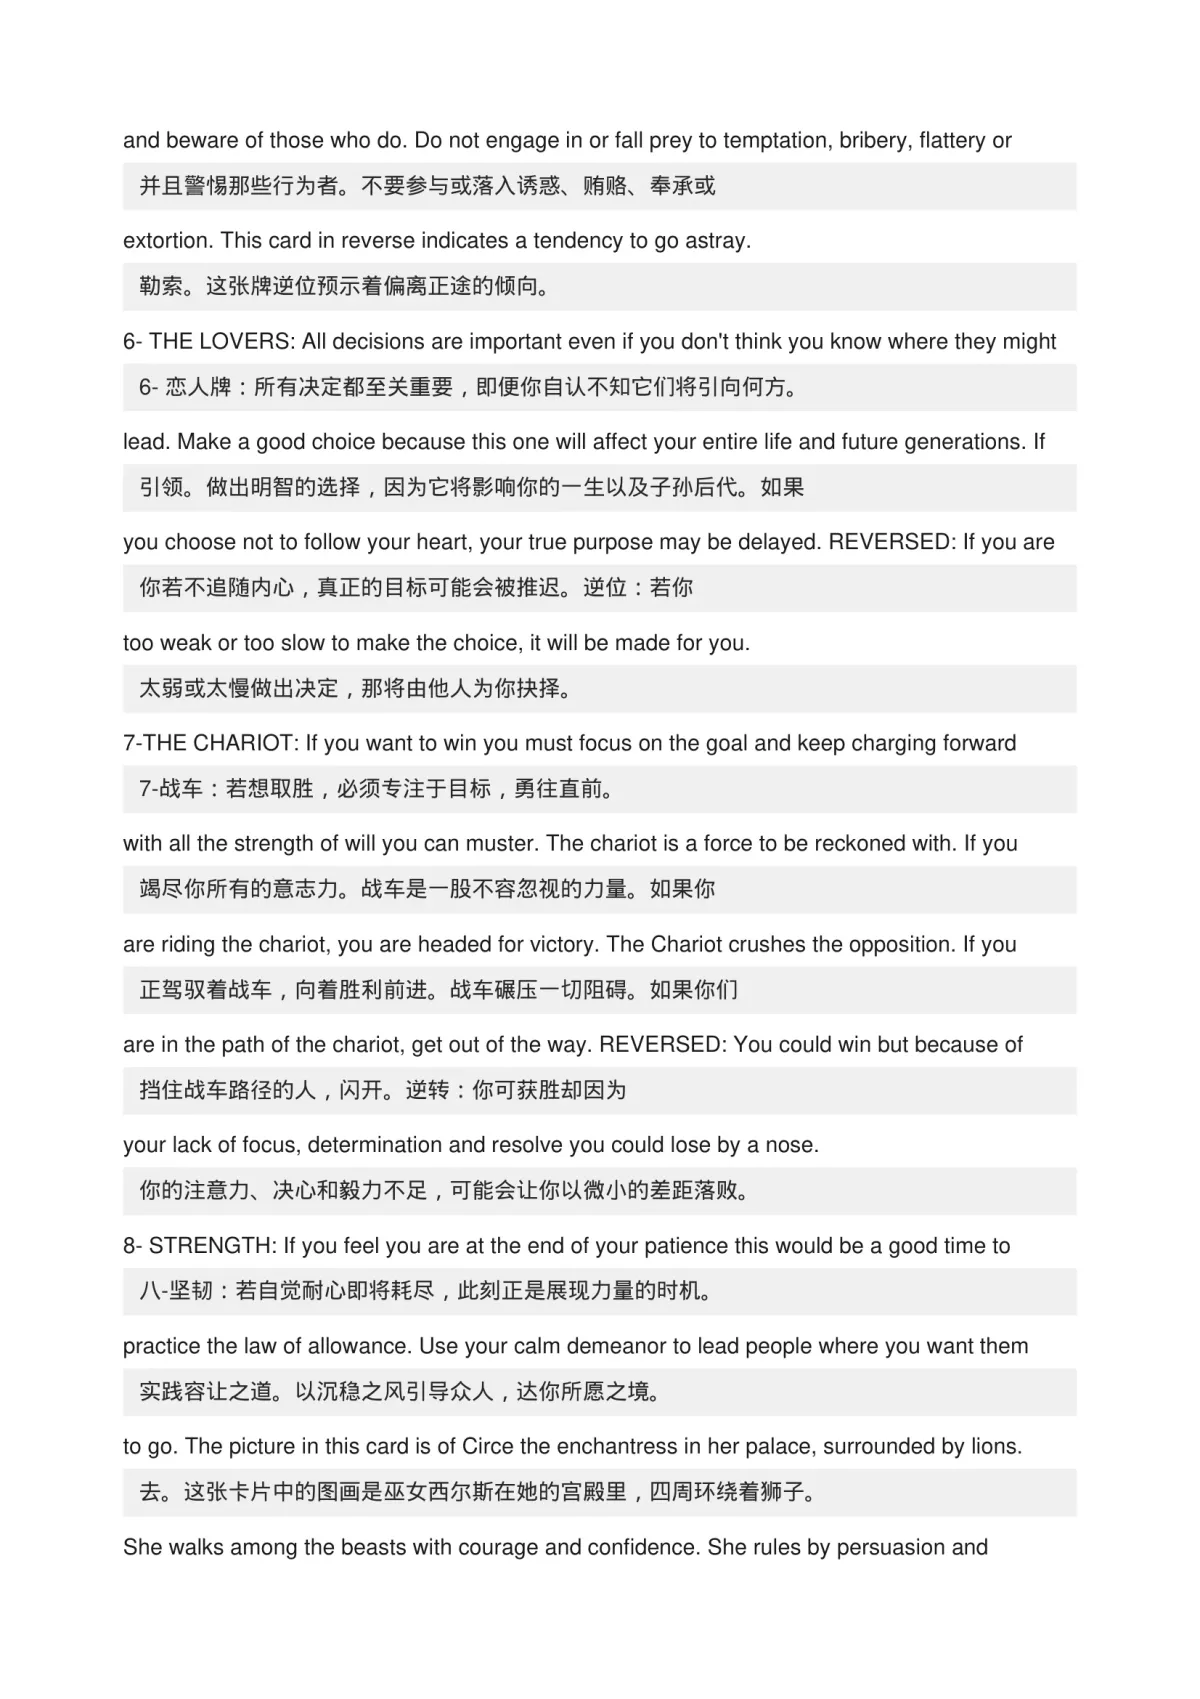
รูปแบบที่ยุ่งเหยิงซ้อนทับกัน
ผลลัพธ์แบบสองภาษาที่มีโครงสร้าง
พร้อมลองใช้โหมด OCR แล้วหรือยัง?
อัปโหลด PDF เปิดโหมด OCR และแปลหน้าที่สแกนให้ได้ผลลัพธ์ที่สะอาดยิ่งขึ้น