איך ליצור כתוביות דו-לשוניות: שתי שפות בקובץ SRT או VTT אחד
צרו קובץ SRT או VTT דו-לשוני שאנשים יכולים לקרוא: מזגו לפי זמן, התאימו שתי שפות לכתובית אחת, בחרו מה יופיע למעלה, והריצו בודק חינמי.
כדי ליצור כתוביות דו-לשוניות, דרושים קובץ כתוביות מתוזמן, תרגום שלו ששומר על אותם זמנים, וכתובית אחת לכל רגע שמכילה את שתי השפות: שורות המקור קודם, ואחר כך שורות התרגום, תחת חותמת זמן אחת. כל מתרגם שכותב קובץ דו-לשוני עושה זאת עבורכם, וכלי מיזוג יעשה זאת אם כבר יש לכם שני קבצים. SRT רגיל אינו דורש תחביר מיוחד לכך.
יצירת הקובץ היא החלק הקל. החלק הקשה הוא שהתזמון נכתב עבור שפה אחת. כתובית שהכילה שתי שורות באנגלית צריכה כעת להכיל ארבע שורות, באותן שניות ספורות, מעל אותה תמונה. לכן מדריך זה מקדיש את רוב זמנו למה לתקן לאחר המיזוג.
כתבנו קובץ בדיקה עם 12 כתוביות, הפקנו גרסאות ספרדית, סינית וערבית, וכתבנו בודק חינמי. הקבצים נוצרו מקוד כתיבת הכתוביות של BookTranslator עצמו, שהורץ באופן מקומי. כתבנו את התרגומים ביד ולא באמצעות מודל, כך שבדיקות אלו מראות מה קורה לקובץ, ולא עד כמה התרגום טוב. הREADME מכיל את הפרטים. הבודק דורש Python 3 ותו לא.
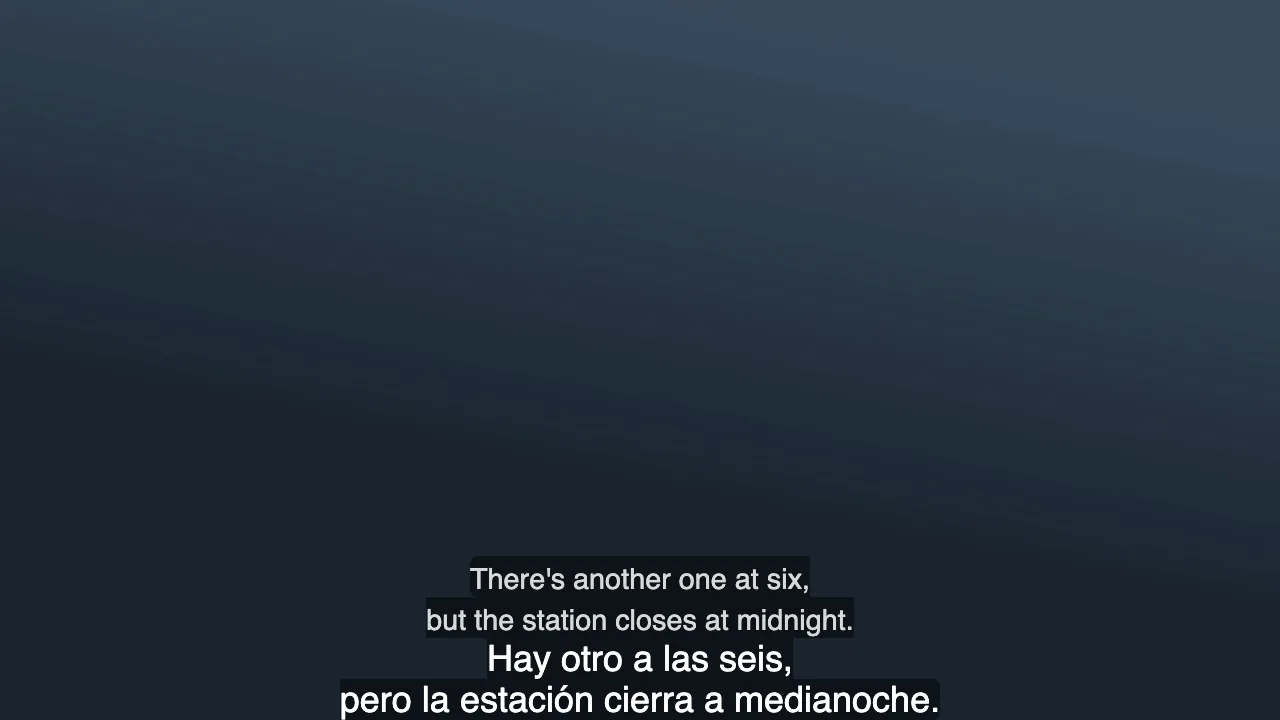
תשובה מהירה: איך נראית כתובית דו-לשונית
2
00:00:03,400 --> 00:00:06,600
There's another one at six,
but the station closes at midnight.
Hay otro a las seis,
pero la estación cierra a medianoche.
זהו SRT תקין. כל כתובית שומרת על המספר וחותמת הזמן שלה, וכל שורת טקסט מתחת לחתימת הזמן מופיעה על המסך יחד. WebVTT עובד באותו אופן.
בחרו את התצורה קודם
| אתם רוצים | השתמשו | למה |
|---|---|---|
| לצפות כמעט בכל נגן, או לשלוח קובץ אחד למישהו | קובץ SRT ממוזג אחד | זהו קובץ כתוביות רגיל, ללא צורך בתכונה מיוחדת בנגן |
| לצפות במחשב שלכם עם שליטה בכל שפה | שני קבצים נפרדים בנגן עם תמיכה בשני מסלולים | כל שפה שומרת על התזמון שלה וניתן להזיז או לכבות אותה |
| להציג את השפות בגדלים שונים בדף אינטרנט | קובץ VTT אחד עם מחלקה לכל שפה | ל-WebVTT יש עיצוב; ל-SRT אין דרך תקנית לעשות זאת |
| לפרסם סרטון שנראה אותו דבר בכל מקום | כתוביות צרובות | הטקסט הופך לחלק מהתמונה, והצופים לא יכולים לכבות אותו |
לשני מסלולים, ל-mpv יש אפשרות --secondary-sid. המדריך שלו אומר שהמסלול השני מצויר כברירת מחדל בראש המסך, מה שמפריד בין השפות. לא בדקנו את mpv בעצמנו.
כדי לצרוב כתוביות לתוך הווידאו, המסנן כתוביות של FFmpeg דורש גרסה עם libass. ל-FFmpeg 9.0.1 שהתקנו לבדיקה הזו לא היה אותו, לכן יש להריץ ffmpeg -filters | grep subtitles לפני שמתכננים על סמך זה. לא בדקנו צריבה.
שלב 1: הכנסת שתי שפות לקובץ אחד
אם יש לך קובץ אחד, תרגם אותו עם כלי שכותב קובץ כפול. BookTranslator עושה זאת לכל עבודת SRT ו-VTT: אתה מקבל קובץ מתורגם וקובץ דו-לשוני עם אותם חותמות זמן, ואתה יכול להתחיל במתרגם הכתוביות. אם אתה צריך לבחור כלי תחילה, ראה את השוואת תוכנות הכתוביות שלנו.
אם יש לך שני קבצים, התאם ביניהם לפי זמן, לא לפי מספר כתובית. כאן האיחוד נכשל, כי שני רצועות של אותו וידאו כמעט ולא מחלקות את השורות באותו אופן. הרצועה הספרדית השנייה שלנו מפצלת שתי כתוביות ארוכות לשניים ומשמיטה את אפקט הקול, השנה והמוזיקה.
python3 check_bilingual_subs.py merge sample-source.srt sample-es-own-timing.srt -o merged.srt
התאמה לפי מספר כתובית (אפשרות --index של הסקריפט) טעתה ב-10 מתוך 12 הכתוביות, החל מכתובית 2, שבה חצי מהספרדית נעלם. בכתובית 3 התרגום כבר היה שייך לשורה אחרת:
3
00:00:06,800 --> 00:00:08,000
So where do we wait?
pero la estación cierra a medianoche.
התאמה לפי זמן נתנה את התרגום הנכון תחת 9 כתוביות, השאירה את 3 הכתוביות ללא ספרדית לבדן, ודיווחה על השורה הספרדית היחידה שלא התאימה לשום דבר, כך שתוכל למקם אותה ידנית. הסקריפט משייך כתובית מהרצועה השנייה לכתובית מהרצועה הראשונה שאיתה יש לה את החפיפה הגדולה ביותר, כל עוד זו מכסה לפחות מחצי מאורכה. כלים כמו submerger גם ממזגים קבצים; לא בדקנו אותם. בכל כלי שתשתמש, בדוק באופן מדגמי את הכתוביות שאחרי הפיצול הראשון.
שלב 2: בדיקת הקובץ
python3 check_bilingual_subs.py check sample-source.srt sample-es-bilingual.srt --max-target-cps 17
הוא משווה את הקובץ הדו-לשוני למקור ומניח שהשורות המקוריות מופיעות ראשונות, לכן הרץ אותו לפני שאתה מחליף את הסדר. הוא מזהיר אותך אם השורות העליונות אינן תואמות למקור. זה מה שהוא מצא בקובץ הספרדי:
| כתובית | שניות | שורות | תווים/שנייה במקור | תווים/שנייה בספרדית | בעיה |
|---|---|---|---|---|---|
| 2 | 3.2 | 4 | 19.4 | 17.8 | ארבע שורות, ספרדית מהירה מדי |
| 5 | 2.7 | 2 | 6.7 | 7.0 | ' בטקסט |
| 7 | 1.0 | 2 | 4.0 | 4.0 | אותו טקסט פעמיים |
| 8 | 1.8 | 2 | 1.7 | 1.7 | אותו טקסט פעמיים |
| 9 | 1.2 | 4 | 20.8 | 22.5 | ארבע שורות, שתי השפות מהירות מדי |
| 10 | 3.6 | 2 | 18.3 | 19.4 | שתי השורות מעל 42 תווים, ספרדית מהירה מדי |
כתוביות 6 ו-12 גם חזרו עם ארבע שורות. ארבע הכתוביות האחרות היו תקינות.
מגבלות המהירות ואורך השורה מגיעות מ-Netflix, כי המספרים שלה פומביים וספציפיים, והם משתנים לפי שפה. המדריך האנגלי שלה מתיר 42 תווים לשורה, שתי שורות, ועד 20 תווים לשנייה עבור תוכניות למבוגרים. המדריך לספרדית אמריקה הלטינית שלה מתיר 17 תווים לשנייה עבור כתוביות מתורגמות, והמדריך לסינית מפושטת שלה מתיר 16 תווים לשורה ו-9 לשנייה. לכן השתמש ב---max-target-line 16 --max-target-cps 9 עבור סינית. המדריכים האלה מכסים שפה אחת בכל פעם, עם שתי שורות לכל היותר. אנחנו לא מכירים תקן מקביל לשתי שפות בכתובית אחת, לכן ברירת המחדל של הבודק לשלוש שורות על המסך, וכל מה שבסעיף הבא, היא שיקול דעתנו.
הבודק גם מדפיס מספר משולב, שהגיע ל-43.3 תווים לשנייה בכתובית 9. אל תנסה לתקן את המספר הזה. אף אחד לא קורא כל תו בשתי השפות בריכוז מלא. התייחס אליו כמצביע לכתוביות שכדאי לשים לב אליהן.
שלב 3: תיקון הכתוביות עם ארבע שורות
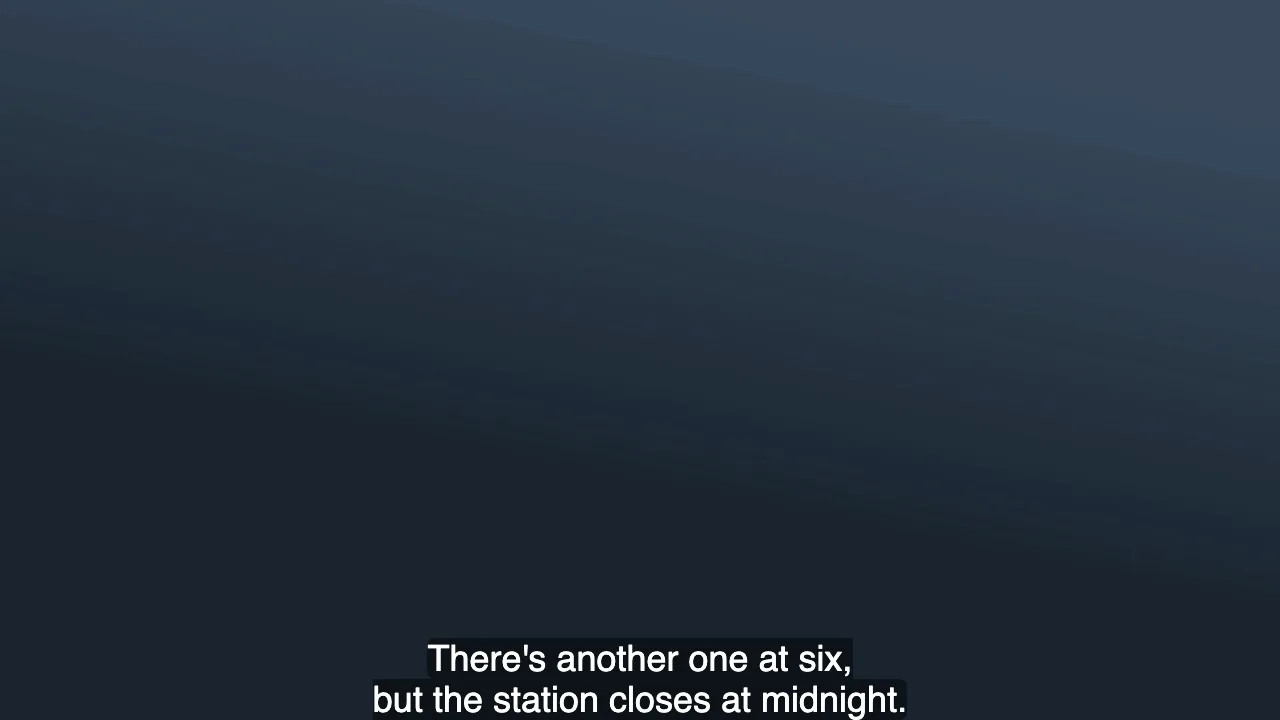
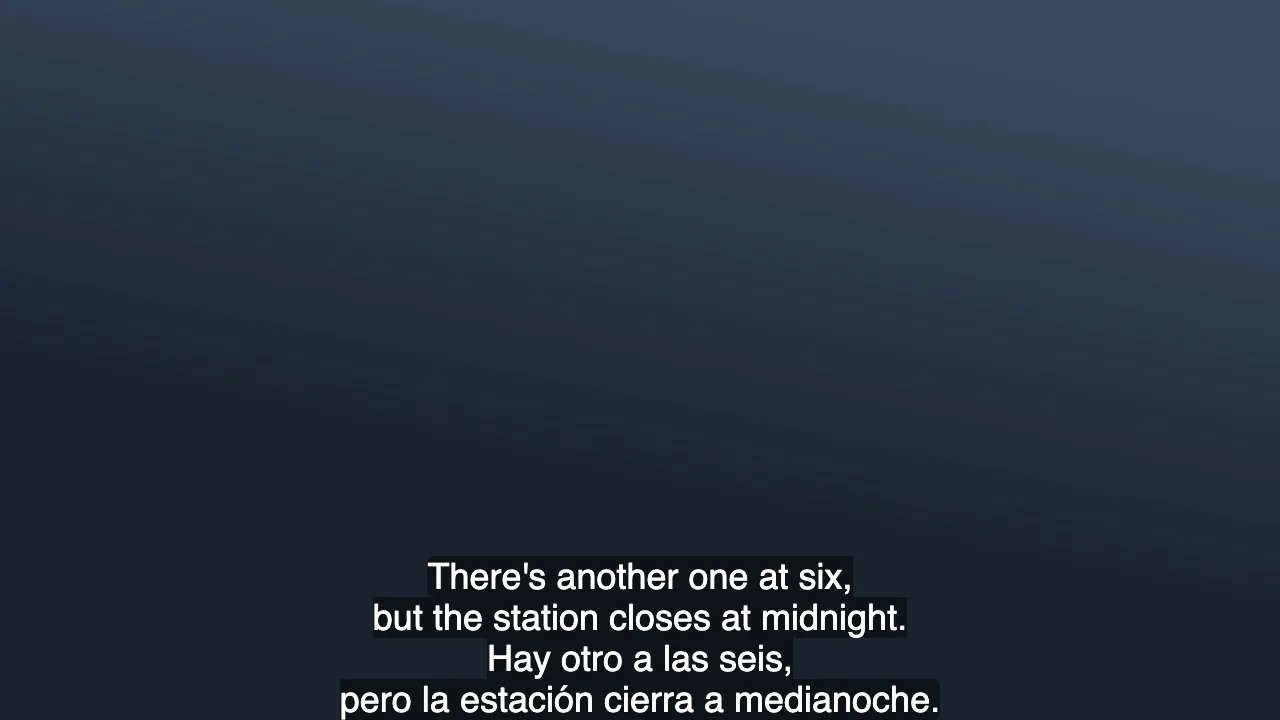
הנה המחיר של ארבע שורות. בתצוגת הכתוביות המובנית של Chromium ברזולוציה 1280x720, כתובית האנגלית בת שתי השורות תפסה 10.6% מגובה הפריים, ואותה כתובית עם ספרדית נוספת תפסה 21.9%.
עברו על הכתוביות המסומנות לפי הסדר הזה:
- השאירו את שפת האודיו מילה במילה. אם אנשים מקשיבים למקור ועוקבים בטקסט, מקור מקוצר כבר לא תואם את מה שהם שומעים.
- קצרו את השפה השנייה לשורה אחת. הכתובית השנייה שלנו עוברת מ-17.8 תווים לשנייה ל-13.1 כאשר הספרדית הופכת ל-
A las seis hay otro; cierran a medianoche.אלו שלוש שורות על המסך במקום ארבע, ושתי העובדות נשמרות. - הוסיפו זמן רק אם יש פער. בדקו את זמן ההתחלה של הכתובית הבאה לפני שאתם מזיזים זמן סיום. לכתובית השנייה יש 0.2 שניות ליתר, וזה לא שווה את המאמץ.
- ואז הניחו לשאר. כתובית 9 היא
You knew?/Since March.ב-1.2 שניות. היא מפרה את מגבלות המהירות והשורות, אבל היינו משאירים אותה: הפער של 0.2 שניות אחריה קטן מדי כדי לעזור, וסביר שצופה יכול לקלוט שתי תשובות קצרות במבט אחד. לא כל סימון הוא באג.
בשורות ארוכות בודדות כמו כתובית 10, פצלו כל שפה לשתי שורות רק אם לכתובית יש את הזמן לכך. אחרת קצרו את התרגום.
אם אתם שולטים בתצוגה, תוכלו גם להקל על זיהוי שפה אחת. הריצו to-vtt כדי לתת לכל שפה מחלקה משלה. הקובץ המתקבל הוצג ב-Chromium כשהאנגלית בגודל 80% ובצבע אפור בהיר. זה בקושי חוסך מקום (21.1% מגובה הפריים במקום 21.9%), כך שזה לא מחליף קיצור שורה. לא בדקנו אם זה עוזר לאנשים לקרוא.
זה משתמש ב-מחלקות כתוביות ובבורר ::cue() של WebVTT. זה מיועד לדפדפנים. נגנים אחרים עשויים להתעלם מהסגנונות או מקובץ ה-VTT.
שלב 4: החליטו איזו שפה תופיע למעלה
יש מחקר בנושא. במחקר מעקב עיניים משנת 2026 בקרב 42 דוברי ספרדית ילידיים עם אנגלית כשפה שנייה, הצופים בילו יותר זמן בשורה העליונה בכל שפה שהיא הייתה, והם בילו יותר זמן בשורה שהתאימה לאודיו. ציוני ההבנה היו גבוהים יותר כשהספרדית, שפתם הראשונה, הייתה למעלה. מחקר מוקדם יותר בקרב 112 לומדי אנגלית סינים מצא שכתוביות דו-לשוניות עזרו להבנה כמו כתוביות בשפתם הראשונה בלבד, ושתיהן עלו על כתוביות באנגלית או על היעדר כתוביות.
אלו מחקרים בודדים של קבוצות ספציפיות של צופים, אז התייחסו אליהם כנקודת מוצא:
- מעקב אחר סרט או הרצאה לשם התוכן: שימו למעלה את השפה שאתם קוראים בה הכי טוב.
- תרגול שפה שאתם לומדים: שימו את השפה הזו למעלה והשלימו עם זה שאולי תבינו קצת פחות. הבנה היא מה שמדד המחקר מ-2026, לא למידה, אז זה השיקול שלנו.
- סקירת תרגום: הסדר לא משנה הרבה, אז השאירו אותו.
הקובץ הדו-לשוני של BookTranslator תמיד שם את המקור למעלה. כדי להחליף:
python3 check_bilingual_subs.py flip sample-source.srt sample-es-bilingual.srt -o translation-on-top.srt
מה חוזר שגוי, ואיך לתקן
אלה הגיעו מהרצת קוד הכתוביות של BookTranslator על קובצי הבדיקה שלנו, והבודק מסמן את השניים הראשונים.
- טקסט שלא צריך תרגום מופיע פעמיים.
1984ו-♪ ♪מדולגים ככאלה שאין בהם מילים לתרגום, כך שהקובץ הדו-לשוני מדפיס כל אחד מהם פעמיים. מחקו שורה אחת ידנית. 'יכול להופיע בטקסט. נכון לנובמבר 2026, כתובית עם תגי עיצוב וגרש יכולה לחזור עם גרש מקודד. השורה המקורית שלנו הפכה ל-<i>Don't answer that.</i>בקובץ הדו-לשוני, ובבדיקת VTT נפרדת תרגום צרפתי הפך ל-<i>Je n'attendrai pas.</i>גם בקובץ המתורגם. Chromium פענח אותו ב-VTT והציג גרש רגיל. אבל כשהמרנו את ה-SRT עם FFmpeg, ה-'נשאר בטקסט הפלט, אז הניחו שכמה נגנים יציגו אותו כפשוטו. החליפו את'ב-'לפני שאתם משתמשים בקובץ. דיווחנו על כך למהנדסים שלנו.- הגדרות כתוביות VTT מוסרות. הגדרות מיקום כגון
line:0 align:start position:10%ובלוקיNOTEנעלמו מפלט בדיקת ה-VTT שלנו, ותוויות דובר הופיעו בשתי השורות. אם ה-VTT שלכם מסתמך על מיקום, הוסיפו אותו בחזרה לאחר התרגום. - טקסט מימין לשמאל מסומן שורה אחר שורה. שורות בערבית חזרו עטופות בסימני כיווניות של יוניקוד. בדקנו רק כתובית אחת, בהעתק VTT של הקובץ ב-Chromium, והיא הוצגה מימין לשמאל. שורות שמערבבות ערבית עם מספרים, כמו הכתובית מספר 10 שלנו, הן המקרה הקשה יותר ולא צפינו בהן, אז כדאי לבדוק בנגן שבאמת משתמשים בו. ל-SRT אין דרך אחרת לקבוע כיווניות. המדריך שלנו לטקסט מימין לשמאל מכסה את הסוגיות הרחבות יותר בספרים.
אם קובץ המקור הוא ASS או SSA, הפלט הדו-לשוני של BookTranslator מוסיף את השורה המתורגמת כאירוע שני עם אותו סגנון ותזמון, וזו מבנה שונה. המדריך שלנו לכתוביות ASS מסביר איך קבצים כאלה בנויים. אם תווים עם סימני ניקוד נראים שבורים באחת השפות, הבעיה היא בדרך כלל בקידוד של הקובץ, וזה מכוסה במדריך שלנו לקידוד כתוביות.
לפני שמשתפים את הקובץ
- הריצו את הבודק ועברו על כל כתובית שסומנה.
- מצאו
',&ו-"והחליפו אותם. - מחקו שורות כפולות באפקטי קול, במספרים ובמוזיקה.
- צפו בכמה הדקות העמוסות ביותר בנגן שהצופים שלכם ישתמשו בו, בגודל המסך שבו ישתמשו.
- בדקו שהשורות התחתונות לא מכסות טקסט שמופיע על המסך בסרטון.
- קראו את התרגום בהקשר. זרימת העבודה שלנו לתרגום כתוביות עם AI מסבירה איך לסקור אותו.
יש לכם קובץ SRT או VTT מוכן? העלו אותו למתרגם הכתוביות וראו את המחיר לפני שאתם משלמים. כשהתרגום מסתיים, הורידו את הקובץ הדו-לשוני יחד עם הקובץ המתורגם. אחר כך הריצו עליו את הבודק, כי מספרי השורות בעבודה אמיתית תלויים באופן שבו המודל מפצל כל כתובית מתורגמת.
פוסטים קשורים