כיצד לתרגם PDF תוך שמירה על הפורמט
השתמשו בתהליך עבודה עקבי ל-PDF כדי לשמור על סדר הקריאה, טבלאות, תרשימים, גופנים, טקסט מימין לשמאל ופריסת העמוד במהלך התרגום.

תשובה מהירה: שמרו על המבנה המשמעותי של המסמך, לא על כל קואורדינטה
כדי לתרגם PDF בלי לאבד את הפורמט, קבעו תחילה אם הוא מכיל טקסט שניתן לבחור, תמונות סרוקות, או את שניהם. לאחר מכן בדקו את העמוד המייצג הקשה ביותר עם מתרגם PDF המודע לפריסה לפני עיבוד הקובץ המלא. בדקו בנפרד את סדר הקריאה, גלישת טקסט, טבלאות, תוויות תרשימים, הערות שוליים, גופנים וטקסט מימין לשמאל.
המטרה אינה זהות ברמת הפיקסל. תרגום יכול להזיז מעבר שורה או להוסיף עמוד ועדיין לשמר את המסמך כראוי. הוא נכשל כאשר מידע נעלם, עובר לשורת טבלה שגויה, הופך לבלתי קריא, או מאבד את הקשר שלו לכיתוב, להערת שוליים או לוויזואל.
השתמשו בטבלת ההחלטות הזו כנקודת התחלה:
| ה-PDF שברשותכם | פעולה ראשונה | סיכון עיצובי עיקרי |
|---|---|---|
| PDF דיגיטלי עם טקסט שניתן לבחור | תרגמו עמוד קשה אחד ישירות | סדר קריאה וגלישת תיבת טקסט |
| PDF סרוק או מצולם | הריצו OCR, בדקו את שכבת הטקסט, ואז תרגמו | שגיאות OCR שהופכות לשגיאות תרגום |
| PDF עם טבלאות או תרשימים צפופים | בדקו עמוד עם תאים ממוזגים, מספרים ותוויות | פריסה שנראית נכון עם קשרי נתונים שגויים |
| מאמר או דוח בשתי עמודות | בדקו חילוץ וסדר קריאה לפני שיפוט השטף | עמודות שמתמזגות או פסקאות שמתורגמות שלא לפי הסדר |
| טופס, תעודה או תבנית קבועה | החליטו אילו קואורדינטות והפניות לעמודים קבועות מבחינה חוקית או תפעולית | חיתוך שנגרם מאזורי טקסט נוקשים |
| עותק לבדיקה דו-לשונית | בחרו קבצים זה-לצד-זה, משולבים, עמודים ממול, או מסונכרנים | עמודות צרות ויישור מקור-יעד לא יציב |
זהו תהליך העבודה המרכזי של קטגוריית תרגום PDF. אם אתם בוחרים בין מוצרים ולא מאבחנים קובץ, התחילו עם השוואת מתרגמי PDF. אם אינכם מצליחים לסמן טקסט כלשהו, עברו ישירות לתהליך העבודה של PDF סרוק ו-OCR.
מה "שמירה על העיצוב" אמורה למעשה לומר
שימור עיצוב אינו תכונה אחת של עובר/נכשל. יש לו לפחות חמש שכבות:
- שלמות התוכן: כל פסקה, תווית, אזהרה, מספר והערה בעלי משמעות נשארים במקומם.
- מבנה לוגי: כותרות, רשימות, תאי טבלה, כיתובים, הערות שוליים וסדר הקריאה עדיין מבטאים את אותם היחסים.
- היררכיה חזותית: כותרות עדיין נראות כמו כותרות, כיתובים נשארים כפופים, ואובייקטים קשורים נשארים מקובצים.
- תמיכה בכתב: הגופנים הנבחרים מכילים את הגליפים של שפת היעד, והכיווניות והפיסוק מוצגים כראוי.
- שמישות העמוד: התוצאה נשארת קריאה בגודל רגיל ללא חיתוך, חפיפה או הקטנת גופן indiscriminate.
התיעוד של Adobe ל-PDF מתאר תוכן עמוד גלוי כרשימה של אובייקטים ופעולות סימון, ולא כרצף דמוי Word של פסקאות ניתנות לעריכה. הוא גם מבדיל בין המבנה הלוגי של המסמך לבין המיקום החזותי שלו. הבחנה זו מסבירה מדוע PDF יכול להיראות תקין בעוד שהטקסט המועתק, סדר הנגישות או סדר התרגום שגויים. ראו את התיעוד של Adobe על תוכן עמוד PDF ומבנה לוגי ב-PDF מתויג.
הכלל המעשי פשוט: השוו את המסמך המתורגם ברמת היחסים, לא רק בצילומי מסך.
מבחן עומס לשחזור פריסת PDF
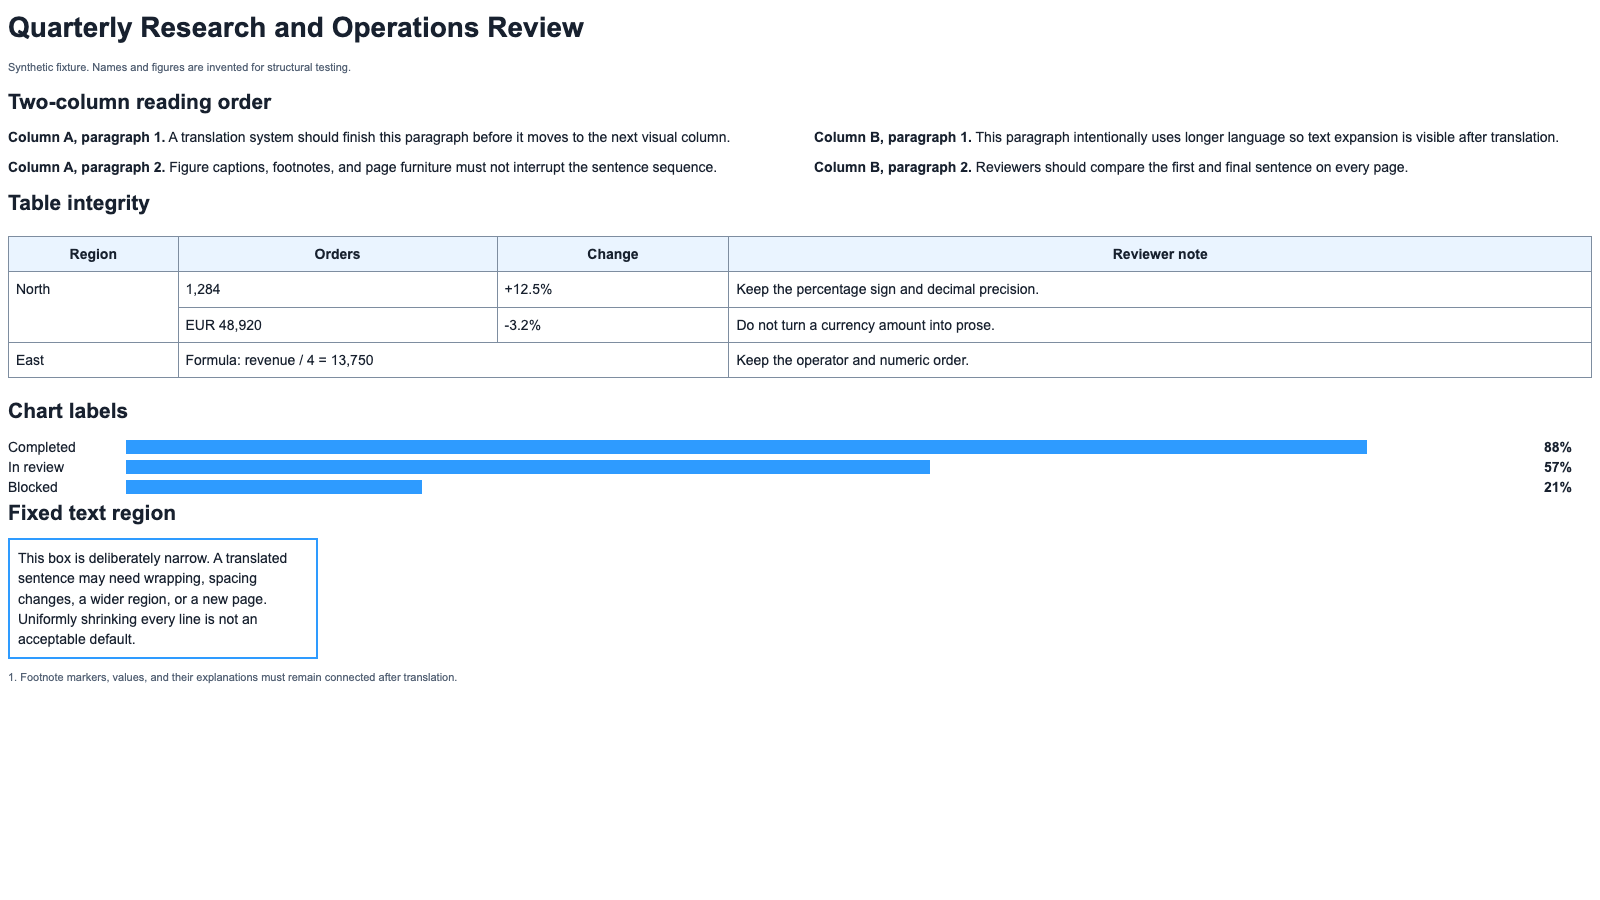
יצרנו מבחן עומס לתרגום פריסת PDF סינתטי בן שני עמודים, כדי שניתן יהיה לבדוק את החלקים הקשים של PDF ללא מסמכי לקוחות. זהו PDF מתויג בגודל A4, עם שמות ונתונים מומצאים. זהו כלי בדיקה, לא השוואת ספקים ולא הוכחה שכלים כלשהם מפיקים תרגום מדויק.
עמוד 1 בודק:
- סדר קריאה בשתי עמודות;
- טבלה עם תא ממוזג;
- מספר שלם, סכום כספי, אחוז עם סימן ונוסחה;
- תוויות תרשים שמיקומן נושא משמעות;
- אזור טקסט קבוע וצר בכוונה;
- הערת שוליים שחייבת להישאר מחוברת לסמן שלה.
עמוד 2 מציב טקסט באנגלית, גרמנית, סינית וערבית בתוך תיבות בגודל זהה. הוא חושף ארבע בעיות שונות: התרחבות מקומית, גלישת שורות, גליפים חסרים ופריסה דו-כיוונית.
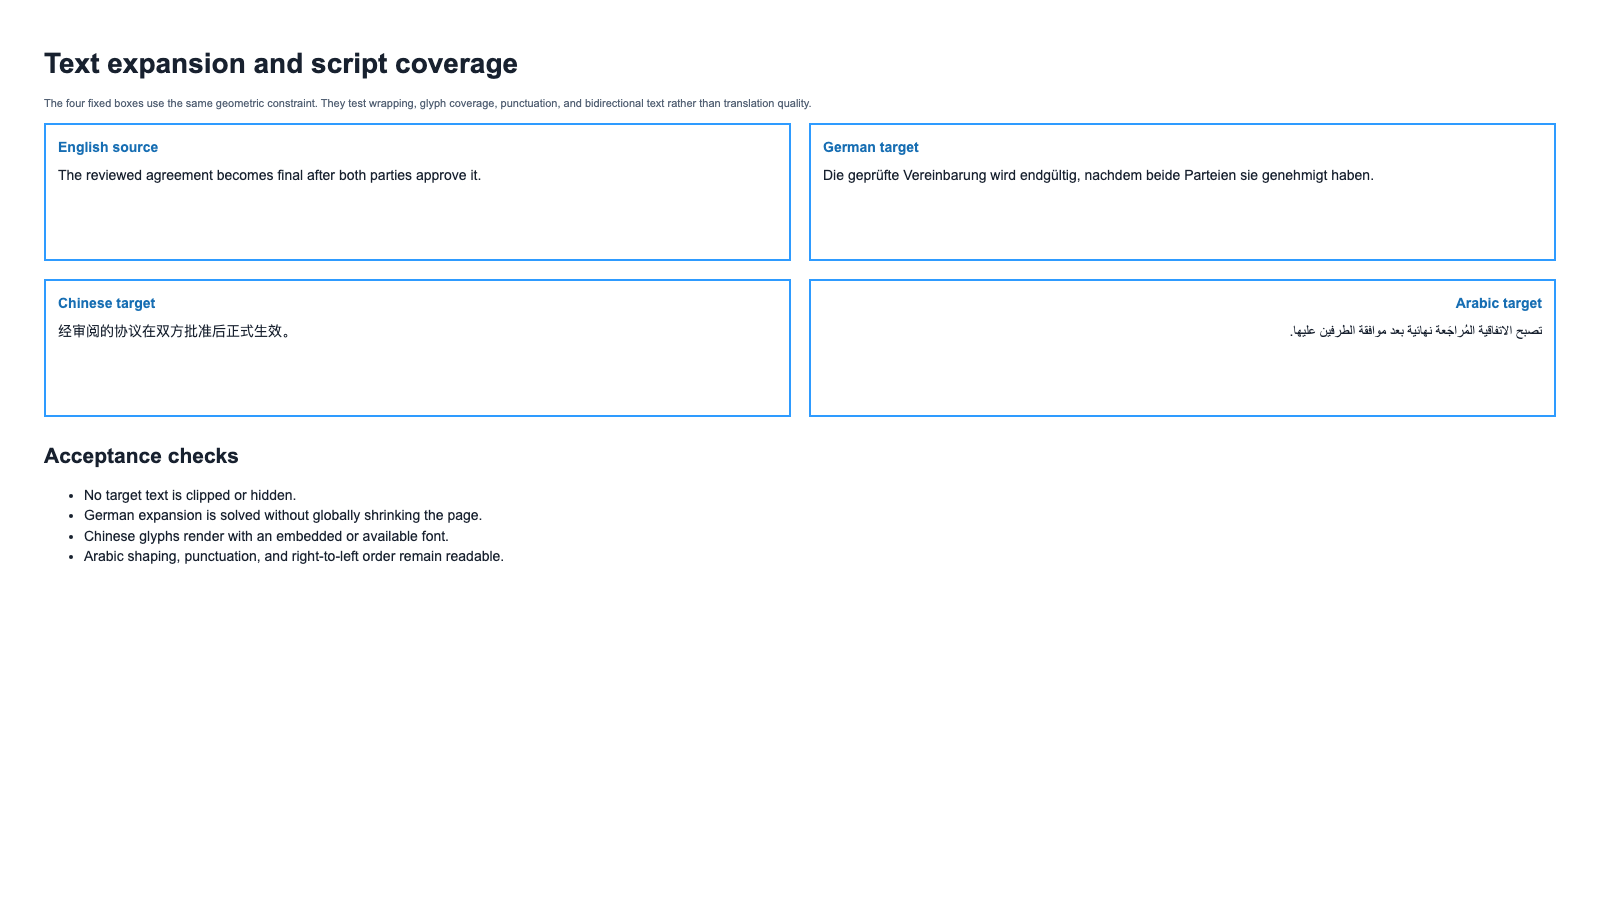
ההנחיות של W3C בנושא גודל טקסט בתרגום מסבירות מדוע תוויות קצרות ואזורים מוגבלים בצורה הדוקה יכולים להתרחב באופן לא פרופורציונלי, בעוד שתרגומים אחרים עשויים להתכווץ. האלגוריתם הדו-כיווני של Unicode מפרט כיצד תווים משמאל-לימין ומימין-לשמאל מעורבים נפתרים. אף אחת מהבעיות הללו לא ניתנת לפתרון אמין על ידי ספירת תווים במקור.
הורד את קובץ הבדיקה והרץ אותו דרך כל תהליך עבודה שאתה שוקל. תעד את הכלי, התאריך, ההגדרות, שפת המקור, שפת היעד וקובץ הפלט. זה הופך את "העיצוב נראה בסדר" לבדיקה ניתנת לשחזור.
אבחן את ה-PDF שלך לפני תרגומו
1. בדוק אם הטקסט ניתן לבחירה
נסה לבחור משפט אחד ותא טבלה אחד.
- אם שניהם נבחרים בצורה נקייה, כנראה של-PDF יש שכבת טקסט שמישה.
- אם כל העמוד נבחר כתמונה אחת, הוא זקוק ל-OCR.
- אם הטקסט נבחר בשברים זעירים או ששורות שהועתקו מגיעות שלא בסדר, המיקום החזותי אינו זהה למבנה הלוגי.
Adobe מציינת ש-PDF סרוק מכיל בתחילה נתוני תמונה ולא טקסט הניתן לחיפוש. OCR מוסיף שכבה הניתנת לבחירה ולחיפוש, אך Adobe גם ממליצה לבדוק שגיאות זיהוי לאחר העיבוד. ראה זיהוי טקסט ב-PDF סרוקים.
2. העתק קטע קשה לעורך טקסט פשוט
עשה זאת עם פסקה בשתי עמודות, שורת טבלה מלאה וכיתוב. אם הסדר שהודבק שגוי לפני התרגום, שכבת התרגום מתחילה מהרצף השגוי.
תיעוד כלי סדר הקריאה של Adobe מראה שטבלאות מורכבות, איורים, עמודות צמודות ורכיבי עמוד עשויים להזדקק לתיקון סדר ותיוג מפורש. שטף לא יכול לתקן פסקה שהורכבה משברים שגויים.
3. בחר את העמוד המייצג הקשה ביותר
אל תבדוק את עמוד השער. בחר את העמוד שסביר ביותר להיכשל:
- הטבלה הצפופה ביותר;
- סרגל הצד או תיבת ההערה הצר ביותר;
- עמוד בשתי עמודות עם הערת שוליים;
- תרשים עם תוויות קצרות;
- עמוד המכיל CJK, ערבית, דוונאגרי או כתבים מעורבים;
- סריקה עם ניגודיות נמוכה או הטיה.
אם העמוד הקשה ביותר נכשל, תרגום של 200 עמודים קלים יותר תחילה רק יוצר יותר עבודת ניקוי.
4. תעד את האילוצים שאינם ניתנים למשא ומתן
מסמכים שונים דורשים הגדרות שונות של "נשמר".
| סוג המסמך | בדרך כלל בלתי ניתן למשא ומתן | בדרך כלל גמיש |
|---|---|---|
| חוזה או טופס | שלמות הסעיפים, תוויות, חתימות, הפניות לעמודים | גלישה מקומית ושינויי ריווח מתונים |
| מאמר אקדמי | משוואות, ציטוטים, קשרי איורים, סדר קריאה | מספר עמודים ומעברי שורה בפסקאות |
| דוח שנתי | מספרים, יחידות, שורות טבלה, שיוך תרשימים | גלישת תוויות וגודל אזור מקומי |
| מדריך | אזהרות, סדר שלבים, הערות צד, הפניות לתמונות | עימוד וזרימה מחודשת מבוקרת |
| ספר או דוח ארוך | סדר פרקים, כותרות, הערות, מיקום תמונות | מספר עמודים וזרימת פסקאות |
רשמו את האילוצים האלה לפני בחירת תיקון. אחרת, סוקרים נוטים להגן על דמיון חזותי גם כשהוא פוגע במשמעות.
תהליך העבודה הבטוח מקצה לקצה
שלב 1: שמרו על המקור וקבעו קו בסיס
שמרו קובץ מקור שלא נגעתם בו. תעדו את מספר העמודים, סוג הקובץ, השפה, האם ה-PDF מתויג, והאם הטקסט ניתן לבחירה. אם המסמך יעודכן מאוחר יותר, שמרו גם את מסמך המקור המקורי וגם את ה-PDF.
שלב 2: הפעילו OCR רק בעת הצורך
עבור עמודים שהם תמונה בלבד, הפעילו OCR בשפת המקור הנכונה. בדקו שמות, מספרים, סימני פיסוק, טבלאות, הערות שוליים ואזורים בעלי ניגודיות נמוכה לפני התרגום. שגיאות OCR הן שגיאות במעלה הזרם: מערכת תרגום יכולה להפיק פלט רהוט מטקסט שזוהה באופן שגוי.
המדריך הייעודי לקובצי PDF סרוקים מכסה בפירוט רב יותר ניקוי סריקות, בחירת שפת OCR, תווים חשודים ובדיקות פרטיות.
שלב 3: תרגמו את העמוד המייצג
השתמשו בתהליך עבודה שמיועד להחזיר מסמך, לא רק טקסט מתורגם. עבור רוב קובצי ה-PDF המעוצבים, המשמעות היא העלאת קובץ הבדיקה אל מתרגם ה-PDF של BookTranslator, בחירת צמד השפות ובדיקת קובץ ה-PDF המוחזר.
אל תעריכו רק את הפסקה הקלה ביותר. השוו את המרכיבים המדויקים שרשמתם בקו הבסיס.
שלב 4: בדקו את המבנה לפני הניסוח
בדקו לפי הסדר הזה:
- האם כל האזורים מהמקור נכללו?
- האם סדר הקריאה נכון?
- האם שורות טבלה, תוויות תרשים, כיתובים והערות שוליים עדיין מפנים לאובייקטים הנכונים?
- האם מספרים, שמות, יחידות ונוסחאות נשמרו כפי שהם?
- האם הכתב של שפת היעד מוצג כראוי?
- רק לאחר מכן: האם התרגום רהוט ומדויק?
תרגום מלוטש של סדר טקסט שגוי הוא עדיין מסמך כושל.
שלב 5: תרגמו את הקובץ המלא ודגמו עמודים בסיכון
לאחר שהעמוד המייצג עובר, תרגמו את כל קובץ ה-PDF. בדקו את ההופעה הראשונה, האמצעית והאחרונה של כל מבנה בסיכון, במקום לבדוק רק את העמוד הראשון.
עבור דוח ארוך, המשמעות עשויה להיות:
- העמוד הראשון והאחרון עם שתי עמודות;
- הטבלה הפשוטה והצפופה ביותר;
- תרשים סמוך להתחלה ולסוף;
- כל עמוד אזהרה;
- כל עמוד שבו הכתב או הגופן של שפת היעד משתנים.
שלב 6: הפעילו את התיקון ההרסני ביותר
תקנו בעיה מקומית באופן מקומי. אל תקטינו את המסמך כולו בגלל כותרת אחת ארוכה.
תיקון גלישת טקסט בלי להקטין הכול
טקסט מתורגם גולש אל מחוץ לאזור כאשר הניסוח בשפת היעד כבר אינו מתאים לגיאומטריה של אזור המקור. הסיבה המיידית עשויה להיות התרחבות טקסט, אך האילוץ המכריע הוא בדרך כלל תיבה, עמודה, שורה, גופן או כלל שבירת שורות מסוים.
יש להחיל תיקונים בסדר הזה:
| סדר | תיקון | מתי להשתמש | סיכון עיקרי |
|---|---|---|---|
| 1 | אפשר גלישה טבעית | באזור יש מקום אנכי לא מנוצל | הזחת רשימה או גובה שורה עשויים להשתנות |
| 2 | כוונן ריווח שורות או פסקאות מקומי | הגלישה קטנה | טקסט צפוף עלול להיות קשה יותר לקריאה |
| 3 | הרחב או הגדל את האזור המושפע | המרחב הלבן הסמוך באמת אינו מנוצל | עצמים סמוכים עשויים לזוז |
| 4 | סדר מחדש אלמנטים סמוכים | כמה בלוקים מתחרים על מקום | היררכיית העמוד והפניות עלולים לסטות |
| 5 | השתמש במונח יעד מקוצר מאושר | קיים מונח תקני ותמציתי | המשמעות מחייבת בדיקה דו-לשונית |
| 6 | הוסף עמוד המשך | התוכן אינו יכול להיכנס באופן קריא | עימוד משתנה |
| 7 | הקטנת גופן מקומית | הקטנה קטנה נותרת קריאה | נגישות ועקביות חזותית |
אל תסתמכו על אחוז התרחבות יחיד של שפה. פסקה בגרמנית עשויה להתאים בעוד שכותר מורכב ייכשל. טקסט בסינית עשוי להתכווץ בעוד שכתובת URL שלא תורגמה עדיין חורגת מתא. ערבית עשויה להתאים לפי מספר תווים אך להיכשל משום שהגופן, העיצוב, הפיסוק או הכיווניות שגויים.
השתמשו באבחון הזה:
- חיתוך בתיבה אחת: שנו את גודל האזור הזה או את זרימת הטקסט בו.
- ריבועים או תווים חסרים: החליפו או הטמיעו גופן עם הגליפים הנדרשים.
- מילים ארוכות או כתובות URL מסרבות להישבר: תקנו את כללי שבירת השורות או המיקוף.
- רק כותרות הטבלה נכשלות: השתמשו בתיקון ייעודי לטבלאות.
- כותרות חוזרות מתנגשות בכל עמוד: עדכנו את תבנית העמוד ולא כל פסקה בנפרד.
- שני קטעים הופכים לפסקה אחת גדולה מדי: תקנו את סדר הקריאה לפני שאתם נוגעים בטיפוגרפיה.
אם בפריסת המקור אין מקום לגרסה נאמנה בשפת היעד, קואורדינטות זהות הן קריטריון קבלה שגוי. שמרו במקום זאת על שלמות, היררכיה וקריאות.
שמירה על טבלאות, תרשימים, מספרים והערות שוליים
טבלת PDF לא תמיד נשמרת כטבלה. היא עשויה להיות טקסט ניתן לעריכה מעל קווי רשת, קטעים ממוקמים רבים, או תמונה אחת. תווית בתרשים עשויה להיות טקסט נפרד או מוטבעת בגרפיקה.
זה יוצר ארבעה סוגי כשל בלתי תלויים:
| סוג הכשל | דוגמה | מדוע בדיקה חזותית בלבד מפספסת אותו |
|---|---|---|
| מבני | תא ממוזג מתפצל או שני תאים הופכים למשפט אחד | התוצאה עשויה עדיין להיראות מיושרת |
| מספרי | -3.2% מאבד את סימן המינוס או עובר לשורה אחרת | טקסט רהוט מסיח את הדעת מהערך |
| חזותי | כותרת מתורגמת חוצה גבול | ייתכן שהטקסט עדיין שלם |
| הפנייתי | סימן הערת שוליים מאבד את ההערה שלו | ייתכן ששני החלקים עדיין מופיעים במקום אחר |
השתמשו בבדיקת אסימונים מוגנים עבור:
- מספרים שלמים וערכים עשרוניים;
- סימנים חיוביים ושליליים;
- אחוזים, מטבעות, תאריכים ומספרי גרסה;
- יחידות ונוסחאות;
- מספרי טבלאות ואיורים;
- סימני הערות שוליים והטקסט המסייג שלהם.
מוסכמות מקומיות עשויות לשנות מפרידים עשרוניים או מיקום מטבע. השאלה אינה אם כל תו זהה; אלא אם היעד מייצג את אותה כמות ונשאר מחובר לתווית הנכונה.
עבור כל טבלה, ודאו:
- מספר השורות והעמודות עדיין תואם.
- תאים ממוזגים מכסים את אותם רשומות.
- כל מספר נשאר מותאם לתווית המקור שלו.
- יחידות, סימנים ודיוק נכונים.
- הערות שוליים עדיין מסייגות את הערך המיועד.
- גלישת כותרות לא הסתירה תוכן.
עבור כל תרשים, ודאו שהגיאומטריה והנתונים נשארים ללא שינוי, שהתוויות עדיין מזהות את הסימנים החזותיים הנכונים, והכיתובים נשארים מחוברים. אם תוויות מוטבעות בתמונה, השתמשו ב-OCR מודע לתמונות וציירו אותן מחדש, או השאירו את התרשים המקורי עם כיתוב או מקרא מתורגמים. אל תמתחו או תחתכו תרשים כדי להתאים תוויות ארוכות יותר.
אם טבלה פיננסית, מדעית או משפטית מכילה אפילו קשר ערך שגוי אחד, המסמך נכשל ללא קשר למידת הליטוש שלו.
בחרו פריסת PDF דו-לשונית
PDF דו-לשוני שימושי כאשר יש צורך לאמת את תרגום היעד מול המקור. הוא לא בהכרח התוצר הסופי הטוב ביותר.
| משימת סקירה | פריסת ההתחלה הטובה ביותר | פשרה |
|---|---|---|
| עריכה פסקה-אחר-פסקה | מקור משמאל, יעד מימין | עמודות צרות מגבירות גלישה |
| לימוד בנייד או בטאבלט | פסקת מקור ואחריה פסקת יעד | מספר העמודים גדל |
| אסמכתא משפטית או ארכיונית | עמודי מקור ויעד זה מול זה | אורך המסמך כמעט מוכפל |
| טבלאות צפופות ועמודים קבועים | קובצי PDF נפרדים ומסונכרנים של מקור ויעד | דורש מציג או תהליך סקירה ששומר על יישור העמודים |
| מסירה ללקוח | PDF של יעד בלבד בתוספת עותק סקירה דו-לשוני נפרד | יש לתחזק שני קבצים מבוקרים |
אין ליישר לפי שבירות שורה חזותיות. תרגום יכול לפצל משפט מקור אחד לשני משפטי יעד או לאחד שני משפטים קצרים. השתמשו בכותרות, ברצף הפסקאות, במספרי טבלאות, במספרי איורים, בפריטי רשימה ובסמני הערות שוליים כעוגנים יציבים.
פריסה זה-לצד-זה היא ברירת מחדל גרועה כאשר במקור יש כבר מספר עמודות, טבלאות צפופות, הערות שוליים או התרחבות מקומית גדולה. במקרים כאלה, עמודים זה-מול-זה או קובצים חד-לשוניים מסונכרנים שומרים על רוחב קריאה תקין ומקלים על בידוד תקלות.
שתי השפות צריכות להישאר ניתנות לחיפוש ולבחירה כשאפשר. בדקו את סדר הטקסט המועתק, את מטא-נתוני שפת המסמך, את הכותרות, את תגי הטבלאות ואת תיאורי האיורים. אם נגישות היא דרישת חובה, קובצים חד-לשוניים נפרדים לרוב בטוחים יותר ממבנה מורכב של עמודות מתחלפות.
בחרו את הכלי המתאים למשימה
מתרגם PDF ייעודי
השתמשו במתרגם ייעודי עבור קובצי PDF ארוכים, מעוצבים או מיועדים ללקוחות. זוהי נקודת ההתחלה הנכונה כאשר הפלט הנדרש הוא קובץ PDF שמיש נוסף ולא תמלול טקסט.
Google Translate
השתמשו ב-Google Translate להבנה מהירה של מסמכים קצרים ופשוטים כאשר הפריסה אינה התוצר הסופי. עמודים מרובי טורים, סריקות, טבלאות צפופות ופרסום סופי דורשים תהליך עבודה מבוקר יותר. מדריך Google Translate ל-PDF מכסה את תהליך העבודה שלו עם מסמכים ואת סימני הכשל.
ChatGPT
השתמשו ב-ChatGPT עבור קטעים קצרים, הכנת מילון מונחים, החלטות סגנון ובדיקה דו-לשונית. אל תתייחסו לממשק צ'אט כמנוע פריסת עמודים עבור PDF ארוך. תהליך העבודה של ChatGPT עם PDF כולל הנחיות שאוסרות על סיכום ועל הוספת תוכן.
המרת PDF ל-DOCX
המירו תחילה רק כאשר בכוונתכם לערוך או לבנות מחדש את המסמך ידנית. ההמרה עלולה לפצל טבלאות, לשנות את סדר הקטעים ולהפוך תוויות תרשים לתיבות צפות לפני שהתרגום מתחיל. בדקו את העמוד הקשה ביותר לפני שאתם מתחייבים. אם קובץ ה-DOCX המומר נקי מבחינה מבנית, המשיכו עם מתרגם DOCX; אם הוא כבר שבור, התרגום לא יתקן את ההמרה.
מתרגם אנושי או בודק דו-לשוני
השתמשו בבודק מוסמך עבור תוכן משפטי, רפואי, פיננסי, קריטי לבטיחות, אקדמי או מפורסם. תהליך עבודה מבוסס פריסה יכול לשמר כל תיבה בעוד המשמעות עדיין שגויה. השתמשו בדוגמאות תרגום אמיתיות כדי לראות כיצד אנו מפרידים בין בדיקת שפה לבדיקת פריסה.
רשימת בדיקה לקבלת תרגום PDF
חסמים
- טקסט חסר או חתוך
- סדר קריאה שגוי
- פסקאות או תוויות חופפות
- מספרים המשויכים לשורה או לרכיב תרשים שגויים
- נוסחאות, סימנים, יחידות או הפניות ששונו
- גודל גופן בלתי קריא
- גליפים חסרים בשפת היעד
- כיווניות ופיסוק שבורים בערבית או בעברית
- אזהרות, כיתובים או הערות שוליים מוסתרים
פגמים משמעותיים
- גלישה מגושמת אך קריאה
- כיתובים המופרדים מהאיורים
- סטיית עמודים גדולה ובלתי מוסברת
- טיפול לא עקבי בכותרות
- שינויים חוזרים בגודל גופן מקומי
- בלוקים דו-לשוניים המיושרים לקטע המקור הלא נכון
הבדלים קוסמטיים
- סיומות שורה שונות
- שינויים קטנים ברווחים
- שינוי מתון במספר העמודים עם הפניות מתוקנות
- גבהי שורות טבלה שונים במקצת עם כל התוכן גלוי
עבור כל עמוד שנכשל, תעדו את עמוד המקור, סוג האלמנט, התסמין, האילוץ המגביל, התיקון, והאם נדרשת סקירה דו-לשונית של המשמעות. תיעוד כזה שימושי יותר מאשר לומר "העיצוב הותאם".
תהליך עבודה מומלץ לרוב קובצי ה-PDF
- שמרו קובץ PDF מקורי ללא שינויים.
- בדקו אם טקסט ותאי טבלה ניתנים לבחירה.
- הפעילו OCR רק עבור תוכן שהוא תמונה בלבד, ואז בדקו שגיאות זיהוי.
- הורידו את מבחן העומס ל-PDF או בחרו את העמוד הקשה ביותר מהקובץ שלכם.
- תרגמו את העמוד המייצג הזה עם PDF Translator.
- בדקו סדר קריאה, טבלאות, מספרים, תוויות, הערות שוליים, גופנים וכיווניות לפני בדיקת שטף השפה.
- תרגמו את הקובץ המלא רק לאחר שהעמוד המייצג עובר בהצלחה.
- תקנו אילוצים מקומיים באופן מקומי; אל תקטינו את המסמך באופן גלובלי.
- שמרו יחד את המקור, ה-PDF המתורגם, ההגדרות, המילון והערות הבדיקה לצורך עדכונים עתידיים.
עבור משוואות, ציטוטים ופריסות מחקר, המשיכו עם תהליך תרגום מאמרים אקדמיים. אם אתם עדיין מתלבטים אם המקור צריך להיות PDF או EPUB, השתמשו במדריך ההחלטה EPUB מול PDF.