द्विभाषी उपशीर्षक कैसे बनाएं: एक SRT या VTT फ़ाइल में दो भाषाएं
एक दोहरी-भाषा SRT या VTT फ़ाइल बनाएं जिसे लोग पढ़ सकें: समय के अनुसार मर्ज करें, एक क्यू में दो भाषाएं फ़िट करें, चुनें कि कौन ऊपर जाएगा, और एक मुफ़्त चेकर चलाएं।
द्विभाषी उपशीर्षक बनाने के लिए, आपको एक समयबद्ध उपशीर्षक फ़ाइल, उसका एक अनुवाद जो समान समय बनाए रखता है, और प्रत्येक क्षण के लिए एक क्यू चाहिए जिसमें दोनों भाषाएं हों: पहले मूल पंक्तियाँ, फिर अनुवादित पंक्तियाँ, एक ही टाइमस्टैम्प के अंतर्गत। कोई भी अनुवादक जो दोहरी फ़ाइल लिखता है, यह आपके लिए करता है, और यदि आपके पास पहले से दो फ़ाइलें हैं तो एक मर्ज टूल यह करता है। सादे SRT को इसके लिए किसी विशेष सिंटैक्स की आवश्यकता नहीं होती।
फ़ाइल बनाना आसान हिस्सा है। कठिन हिस्सा यह है कि समय एक भाषा के लिए लिखा गया था। अंग्रेजी की दो पंक्तियों में फ़िट होने वाला एक क्यू अब उसी कुछ सेकंड में, उसी चित्र पर, चार पंक्तियों को धारण करना होगा। इसलिए यह मार्गदर्शिका अपना अधिकांश समय इस बात पर खर्च करती है कि मर्ज के बाद क्या ठीक करना है।
हमने एक 12-क्यू परीक्षण फ़ाइल लिखी, स्पेनिश, चीनी, और अरबी संस्करण तैयार किए, और एक मुफ़्त चेकर लिखा। फ़ाइलें BookTranslator के अपने उपशीर्षक लेखन कोड से आईं, जो स्थानीय रूप से चलाई गईं। हमने अनुवाद मॉडल को कॉल करने के बजाय हाथ से लिखे, इसलिए ये परीक्षण दिखाते हैं कि फ़ाइल के साथ क्या होता है, यह नहीं कि अनुवाद कितना अच्छा है। README में विवरण हैं। चेकर को Python 3 और कुछ नहीं चाहिए।
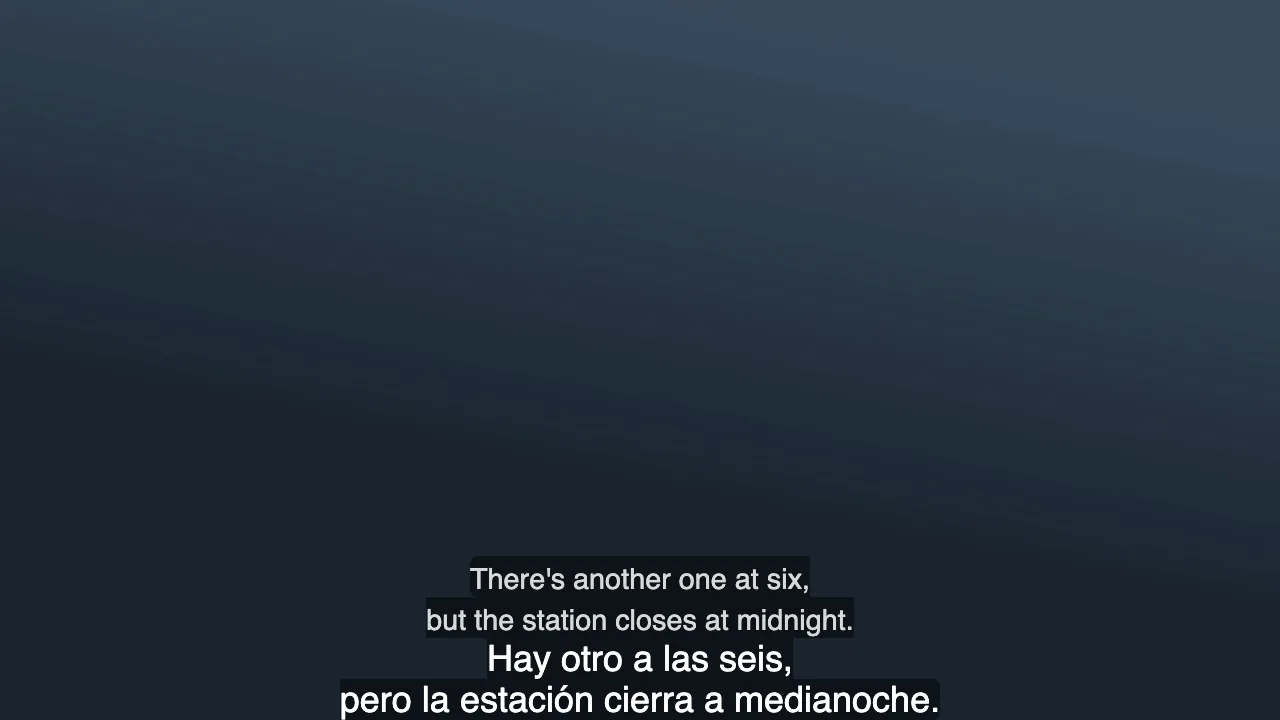
त्वरित उत्तर: द्विभाषी क्यू कैसा दिखता है
2
00:00:03,400 --> 00:00:06,600
There's another one at six,
but the station closes at midnight.
Hay otro a las seis,
pero la estación cierra a medianoche.
यह वैध SRT है। प्रत्येक क्यू अपना नंबर और टाइमस्टैम्प रखता है, और टाइमस्टैम्प के नीचे पाठ की प्रत्येक पंक्ति एक साथ स्क्रीन पर दिखाई देती है। WebVTT भी इसी तरह काम करता है।
पहले सेटअप चुनें
| आप चाहते हैं | उपयोग करें | क्यों |
|---|---|---|
| लगभग किसी भी प्लेयर में देखें, या किसी को एक फ़ाइल भेजें | एक मर्ज किया गया SRT | यह एक साधारण उपशीर्षक फ़ाइल है, जिसके लिए किसी प्लेयर सुविधा की आवश्यकता नहीं है |
| अपने कंप्यूटर पर प्रत्येक भाषा पर नियंत्रण के साथ देखें | दो-ट्रैक समर्थन वाले प्लेयर में दो अलग फ़ाइलें | प्रत्येक भाषा अपना समय रखती है और उसे स्थानांतरित या बंद किया जा सकता है |
| वेब पेज पर भाषाओं को अलग-अलग आकारों में दिखाएं | प्रत्येक भाषा के लिए एक क्लास वाला एक VTT | WebVTT में स्टाइलिंग है; SRT में इसे करने का कोई मानक तरीका नहीं है |
| ऐसा वीडियो प्रकाशित करें जो हर जगह एक जैसा दिखे | बर्न-इन उपशीर्षक | पाठ चित्र का हिस्सा बन जाता है, और दर्शक इसे बंद नहीं कर सकते |
दो ट्रैक के लिए, mpv में --secondary-sid विकल्प है। इसका मैनुअल कहता है कि दूसरा ट्रैक डिफ़ॉल्ट रूप से स्क्रीन के शीर्ष पर खींचा जाता है, जो भाषाओं को अलग रखता है। हमने स्वयं mpv का परीक्षण नहीं किया।
बर्न-इन के लिए, FFmpeg के सबटाइटल्स फ़िल्टर को libass के साथ बिल्ड की आवश्यकता होती है। इस परीक्षण के लिए हमने जो FFmpeg 9.0.1 इंस्टॉल किया था, उसमें यह नहीं था, इसलिए इस पर योजना बनाने से पहले ffmpeg -filters | grep subtitles चलाएँ। हमने बर्न-इन का परीक्षण नहीं किया।
चरण 1: दो भाषाओं को एक फ़ाइल में लाएँ
यदि आपके पास एक फ़ाइल है, तो इसे ऐसे टूल से अनुवादित करें जो दोहरी फ़ाइल लिखता है। BookTranslator हर SRT और VTT कार्य के लिए ऐसा करता है: आपको एक अनुवादित फ़ाइल और समान टाइमस्टैम्प वाली एक द्विभाषी फ़ाइल मिलती है, और आप सबटाइटल अनुवादक से शुरू कर सकते हैं। यदि आपको पहले कोई टूल चुनना है, तो हमारी सबटाइटल सॉफ़्टवेयर तुलना देखें।
यदि आपके पास दो फ़ाइलें हैं, तो उन्हें क्यू नंबर से नहीं, बल्कि समय से जोड़ें। यहीं विलय में गड़बड़ी होती है, क्योंकि एक ही वीडियो के दो ट्रैक अपनी पंक्तियों को शायद ही एक ही तरह से विभाजित करते हैं। हमारा दूसरा स्पेनिश ट्रैक दो लंबे क्यू को आधे में विभाजित करता है और ध्वनि प्रभाव, वर्ष और संगीत को छोड़ देता है।
python3 check_bilingual_subs.py merge sample-source.srt sample-es-own-timing.srt -o merged.srt
क्यू नंबर से जोड़ने (स्क्रिप्ट का --index विकल्प) ने 12 में से 10 क्यू गलत कर दिए, क्यू 2 से शुरू करके, जहाँ आधा स्पेनिश गायब हो गया। क्यू 3 तक अनुवाद एक अलग पंक्ति का हो गया:
3
00:00:06,800 --> 00:00:08,000
So where do we wait?
pero la estación cierra a medianoche.
समय से जोड़ने पर सही अनुवाद 9 क्यू के अंतर्गत आ गया, 3 क्यू जिनमें स्पेनिश नहीं थी, उन्हें अकेला छोड़ दिया, और उस एक स्पेनिश पंक्ति की सूचना दी जो किसी से मेल नहीं खाती, ताकि आप उसे हाथ से रख सकें। स्क्रिप्ट दूसरे ट्रैक के क्यू को पहले ट्रैक के उस क्यू को देती है जिससे वह सबसे अधिक ओवरलैप करता है, बशर्ते कि वह उसकी लंबाई का कम से कम आधा हिस्सा कवर करे। submerger जैसे टूल भी फ़ाइलों को मर्ज करते हैं; हमने उनका परीक्षण नहीं किया। आप जो भी उपयोग करें, पहले विभाजन के बाद क्यू की जाँच करें।
चरण 2: फ़ाइल की जाँच करें
python3 check_bilingual_subs.py check sample-source.srt sample-es-bilingual.srt --max-target-cps 17
यह द्विभाषी फ़ाइल की स्रोत से तुलना करता है और मानता है कि मूल पंक्तियाँ पहले आती हैं, इसलिए क्रम बदलने से पहले इसे चलाएँ। यदि शीर्ष पंक्तियाँ स्रोत से मेल नहीं खातीं तो यह आपको चेतावनी देता है। स्पेनिश फ़ाइल में इसने यह पाया:
| क्यू | सेकंड | पंक्तियाँ | मूल वर्ण/सेकंड | स्पेनिश वर्ण/सेकंड | समस्या |
|---|---|---|---|---|---|
| 2 | 3.2 | 4 | 19.4 | 17.8 | चार पंक्तियाँ, स्पेनिश बहुत तेज़ |
| 5 | 2.7 | 2 | 6.7 | 7.0 | पाठ में ' |
| 7 | 1.0 | 2 | 4.0 | 4.0 | वही पाठ दो बार |
| 8 | 1.8 | 2 | 1.7 | 1.7 | वही पाठ दो बार |
| 9 | 1.2 | 4 | 20.8 | 22.5 | चार पंक्तियाँ, दोनों भाषाएँ बहुत तेज़ |
| 10 | 3.6 | 2 | 18.3 | 19.4 | दोनों पंक्तियाँ 42 वर्णों से अधिक, स्पेनिश बहुत तेज़ |
क्यू 6 और 12 भी चार पंक्तियों के साथ वापस आए। अन्य चार क्यू ठीक थे।
गति और पंक्ति-लंबाई की सीमाएँ Netflix से आती हैं, क्योंकि उसके आंकड़े सार्वजनिक और विशिष्ट हैं, और वे भाषा के अनुसार भिन्न होते हैं। इसकी अंग्रेज़ी गाइड वयस्क कार्यक्रमों के लिए प्रति पंक्ति 42 वर्ण, दो पंक्तियाँ, और प्रति सेकंड 20 वर्ण तक की अनुमति देती है। इसकी लैटिन अमेरिकी स्पेनिश गाइड अनुवादित सबटाइटल के लिए प्रति सेकंड 17 वर्ण की अनुमति देती है, और इसकी सरलीकृत चीनी गाइड प्रति पंक्ति 16 वर्ण और प्रति सेकंड 9 की अनुमति देती है। इसलिए चीनी के लिए --max-target-line 16 --max-target-cps 9 का उपयोग करें। वे गाइड एक समय में एक भाषा को कवर करते हैं, अधिकतम दो पंक्तियाँ। हम एक क्यू में दो भाषाओं के लिए कोई समकक्ष मानक नहीं जानते, इसलिए चेकर का स्क्रीन पर तीन पंक्तियों का डिफ़ॉल्ट, और अगले अनुभाग में सब कुछ, हमारा निर्णय है।
चेकर एक संयुक्त संख्या भी प्रिंट करता है, जो क्यू 9 पर 43.3 वर्ण प्रति सेकंड तक पहुँच गई। उस संख्या को ठीक करने की कोशिश न करें। कोई भी दोनों भाषाओं के हर वर्ण को पूरे ध्यान से नहीं पढ़ता। इसे उन क्यू की ओर संकेत के रूप में लें जिन पर ध्यान देने योग्य है।
चरण 3: चार-पंक्ति वाले क्यू ठीक करें
चार पंक्तियों की यही कीमत है। क्रोमियम के अंतर्निहित सबटाइटल डिस्प्ले में 1280x720 पर, दो पंक्तियों वाले अंग्रेज़ी क्यू ने फ़्रेम की ऊँचाई का 10.6% हिस्सा लिया, और स्पेनिश जोड़ने पर वही क्यू 21.9% तक बढ़ गया।
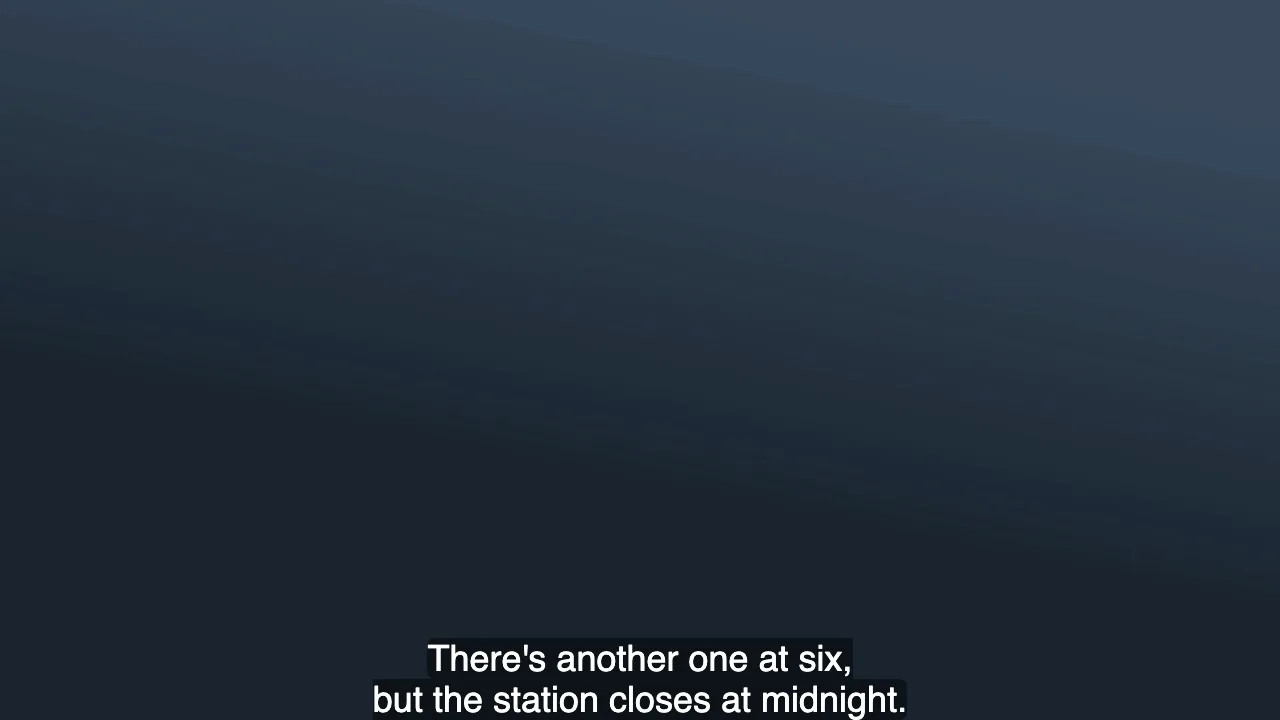
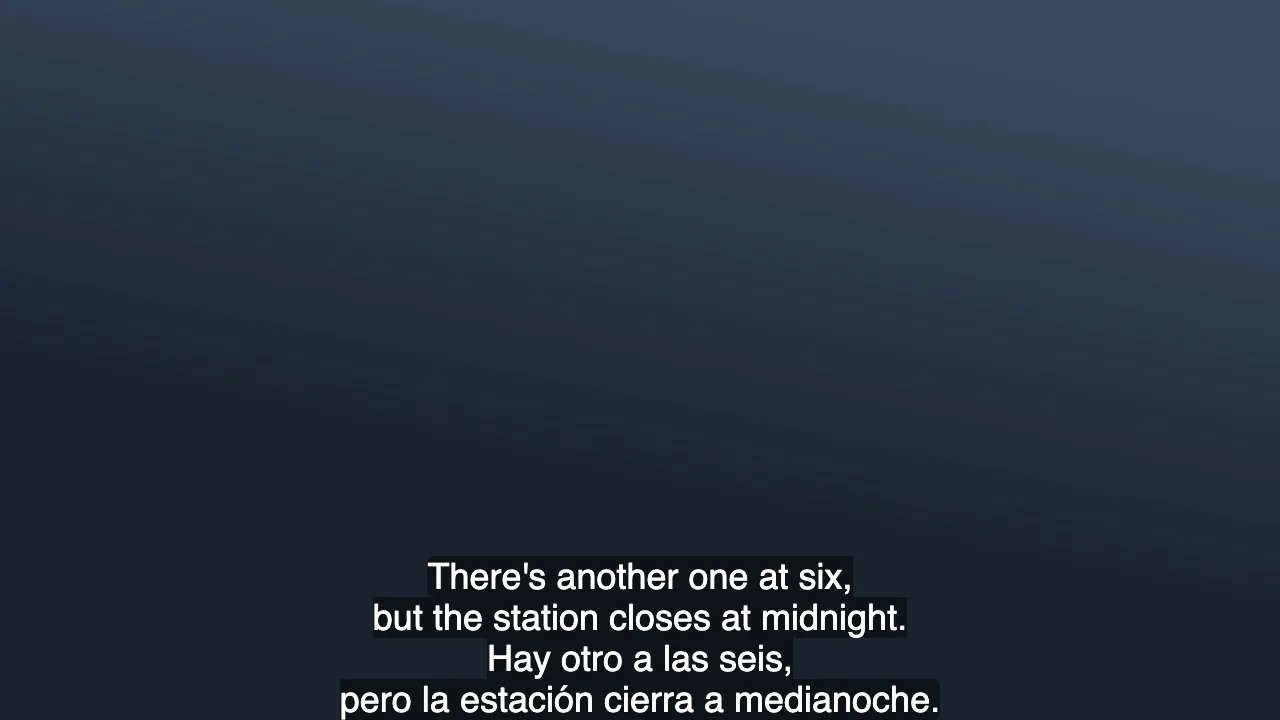
चिह्नित क्यू को इस क्रम में देखें:
- ऑडियो भाषा को शब्दशः रखें। यदि लोग मूल ऑडियो सुन रहे हैं और साथ-साथ टेक्स्ट पढ़ रहे हैं, तो छोटा किया गया मूल टेक्स्ट अब उनकी सुनी हुई बात से मेल नहीं खाएगा।
- दूसरी भाषा को एक पंक्ति में काटें। हमारा क्यू 2 स्पेनिश में
A las seis hay otro; cierran a medianoche.होने पर 17.8 अक्षर प्रति सेकंड से 13.1 पर आ जाता है। स्क्रीन पर चार के बजाय तीन पंक्तियाँ होती हैं, और दोनों तथ्य बने रहते हैं। - समय केवल तभी बढ़ाएँ जब अंतराल हो। समाप्ति समय बदलने से पहले अगले क्यू का प्रारंभ जाँचें। क्यू 2 में 0.2 सेकंड बचे हैं, जो मेहनत के लायक नहीं है।
- फिर बाकी को छोड़ दें। क्यू 9
You knew?/Since March.है, 1.2 सेकंड में। यह गति और पंक्ति सीमाओं का उल्लंघन करता है, लेकिन हम इसे छोड़ देंगे: इसके बाद का 0.2 सेकंड का अंतराल मदद के लिए बहुत छोटा है, और दर्शक संभवतः एक नज़र में दो छोटे उत्तर समझ सकता है। हर चिह्न गड़बड़ी नहीं होता।
क्यू 10 जैसी लंबी एकल पंक्तियों के लिए, प्रत्येक भाषा को दो पंक्तियों में तभी तोड़ें जब क्यू में उसका समय हो। अन्यथा अनुवाद छोटा करें।
यदि आप डिस्प्ले नियंत्रित करते हैं, तो आप एक भाषा को अलग से पहचानने योग्य भी बना सकते हैं। प्रत्येक भाषा को अपनी क्लास देने के लिए to-vtt चलाएँ। परिणामी फ़ाइल क्रोमियम में अंग्रेज़ी को 80% आकार और हल्के धूसर रंग में प्रदर्शित करती है। इससे मुश्किल से जगह बचती है (फ़्रेम की ऊँचाई का 21.9% के बजाय 21.1%), इसलिए यह पंक्ति काटने का विकल्प नहीं है। हमने यह परीक्षण नहीं किया कि इससे लोगों को पढ़ने में मदद मिलती है या नहीं।
यह WebVTT क्यू क्लास और ::cue() सेलेक्टर का उपयोग करता है। यह ब्राउज़र के लिए है। अन्य प्लेयर शैलियों या VTT फ़ाइल को अनदेखा कर सकते हैं।
चरण 4: तय करें कौन सी भाषा ऊपर जाएगी
इस पर कुछ शोध हैं। 42 मूल स्पेनिश वक्ताओं के 2026 आई-ट्रैकिंग अध्ययन में, जिनकी दूसरी भाषा अंग्रेज़ी थी, दर्शकों ने ऊपर की पंक्ति पर अधिक समय बिताया, चाहे वह किसी भी भाषा में हो, और उन्होंने उस पंक्ति पर अधिक समय बिताया जो ऑडियो से मेल खाती थी। समझ के अंक स्पेनिश, उनकी पहली भाषा, के ऊपर होने पर अधिक थे। अंग्रेज़ी सीखने वाले 112 चीनी शिक्षार्थियों के पहले के एक अध्ययन में पाया गया कि द्विभाषी सबटाइटल ने समझ में उतनी ही मदद की जितनी उनकी पहली भाषा में अकेले सबटाइटल ने, और दोनों ने अंग्रेज़ी कैप्शन या बिना सबटाइटल को पीछे छोड़ा।
ये दर्शकों के विशिष्ट समूहों के एकल अध्ययन हैं, इसलिए इन्हें प्रारंभिक बिंदु मानें:
- किसी फ़िल्म या व्याख्यान को उसकी सामग्री के लिए देखना: जो भाषा आप सबसे अच्छी तरह पढ़ते हैं उसे ऊपर रखें।
- किसी सीखी जा रही भाषा का अभ्यास करना: उस भाषा को ऊपर रखें और स्वीकार करें कि आप कुछ कम समझ सकते हैं। 2026 के अध्ययन ने समझ को मापा, सीखने को नहीं, इसलिए यह हमारा निर्णय है।
- किसी अनुवाद की समीक्षा करना: क्रम से बहुत फ़र्क नहीं पड़ता, इसलिए इसे वैसे ही छोड़ दें।
BookTranslator की द्विभाषी फ़ाइल हमेशा मूल को ऊपर रखती है। इसे बदलने के लिए:
python3 check_bilingual_subs.py flip sample-source.srt sample-es-bilingual.srt -o translation-on-top.srt
क्या गलत वापस आता है, और इसे कैसे ठीक करें
ये हमारी परीक्षण फ़ाइलों पर BookTranslator के सबटाइटल कोड चलाने से आए, और चेकर पहले दो को चिह्नित करता है।
- जिस टेक्स्ट को अनुवाद की आवश्यकता नहीं, वह दो बार दिखाई देता है।
1984और♪ ♪को अनुवाद करने के लिए शब्द न होने के कारण छोड़ दिया जाता है, इसलिए द्विभाषी फ़ाइल प्रत्येक को दो बार प्रिंट करती है। एक पंक्ति को हाथ से हटा दें। 'टेक्स्ट में आ सकता है। नवंबर 2026 तक, फ़ॉर्मेटिंग टैग और एपॉस्ट्रॉफ़ी वाला क्यू एपॉस्ट्रॉफ़ी को एस्केप करके वापस आ सकता है। हमारी मूल पंक्ति द्विभाषी फ़ाइल में<i>Don't answer that.</i>हो गई, और एक अलग VTT परीक्षण में एक फ़्रेंच अनुवाद अनुवादित फ़ाइल में भी<i>Je n'attendrai pas.</i>हो गया। क्रोमियम ने इसे VTT में डिकोड किया और सामान्य एपॉस्ट्रॉफ़ी दिखाया। लेकिन जब हमने FFmpeg से SRT को कन्वर्ट किया, तो'आउटपुट टेक्स्ट में बना रहा, इसलिए मान लें कि कुछ प्लेयर इसे शाब्दिक रूप में दिखाएंगे। फ़ाइल का उपयोग करने से पहले'को'से बदलें। हमने यह अपने इंजीनियरों को रिपोर्ट कर दिया है।- VTT क्यू सेटिंग्स हटा दी जाती हैं।
line:0 align:start position:10%जैसी स्थिति सेटिंग्स औरNOTEब्लॉक हमारे VTT परीक्षण आउटपुट से गायब थे, और वक्ता लेबल दोनों पंक्तियों पर दिखाई दिए। यदि आपका VTT प्लेसमेंट पर निर्भर करता है, तो अनुवाद के बाद इसे फिर से जोड़ें। - दाएँ-से-बाएँ पाठ को पंक्ति दर पंक्ति चिह्नित किया जाता है। अरबी पंक्तियाँ यूनिकोड दिशा चिह्नों में लिपटी हुई वापस आईं। हमने केवल एक क्यू देखा, जो क्रोमियम में फ़ाइल की VTT प्रति में था, और वह दाएँ से बाएँ प्रदर्शित हुआ। जिन पंक्तियों में अरबी के साथ संख्याएँ मिश्रित हैं, जैसे हमारा क्यू 10, वे अधिक कठिन मामला हैं और हमने उन्हें नहीं देखा, इसलिए अपने वास्तविक प्लेयर में परीक्षण करें। SRT में दिशा निर्धारित करने का कोई अन्य तरीका नहीं है। हमारी दाएँ-से-बाएँ मार्गदर्शिका पुस्तकों के लिए व्यापक मुद्दों को कवर करती है।
यदि आपका स्रोत ASS या SSA है, तो BookTranslator का द्विभाषी आउटपुट अनुवादित पंक्ति को समान शैली और समय के साथ दूसरी घटना के रूप में जोड़ता है, जो एक अलग संरचना है। हमारी ASS सबटाइटल मार्गदर्शिका बताती है कि उन फ़ाइलों को कैसे संयोजित किया जाता है। यदि किसी भी भाषा में उच्चारण चिह्न वाले अक्षर टूटे हुए दिखते हैं, तो समस्या आमतौर पर फ़ाइल का एन्कोडिंग होती है, जिसे हमारी सबटाइटल एन्कोडिंग मार्गदर्शिका कवर करती है।
फ़ाइल साझा करने से पहले
- चेकर चलाएँ और हर चिह्नित क्यू को देखें।
',&, और"खोजें और उन्हें बदलें।- ध्वनि प्रभावों, संख्याओं और संगीत पर डुप्लिकेट पंक्तियाँ हटाएँ।
- अपने दर्शकों द्वारा उपयोग किए जाने वाले प्लेयर में, उसी स्क्रीन आकार पर, सबसे व्यस्त कुछ मिनट देखें।
- जाँचें कि निचली पंक्तियाँ वीडियो में ऑन-स्क्रीन टेक्स्ट को नहीं ढकती हैं।
- अनुवाद को संदर्भ में पढ़ें। हमारा AI सबटाइटल वर्कफ़्लो बताता है कि इसकी समीक्षा कैसे करें।
क्या आपके पास SRT या VTT तैयार है? इसे सबटाइटल अनुवादक पर अपलोड करें और भुगतान से पहले मूल्य देखें। जब यह पूरा हो जाए, तो अनुवादित फ़ाइल के साथ द्विभाषी फ़ाइल डाउनलोड करें। फिर उस पर चेकर चलाएँ, क्योंकि वास्तविक कार्य में पंक्ति संख्या इस बात पर निर्भर करती है कि मॉडल प्रत्येक अनुवादित क्यू को कैसे तोड़ता है।
संबंधित लेख