バイリンガル字幕の作り方:1つのSRTまたはVTTファイルに2言語を収録する方法
読める二言語SRTまたはVTTファイルを作成:時間でマージし、2言語を1つのキューに収め、どちらを上に表示するかを選び、無料チェッカーを実行します。
バイリンガル字幕を作るには、タイミング付きの字幕ファイルが1つ、同じタイミングを保ったその翻訳、そして各瞬間に両言語を収めたキューが1つ必要です。元の言語の行が先、翻訳された行が後に、同じタイムスタンプの下に配置されます。二言語ファイルを書き出す翻訳ツールならどれでもこれを自動で行い、すでに2つのファイルがある場合はマージツールが行います。プレーンなSRTでは特別な構文は不要です。
ファイルを作るのは簡単な部分です。難しいのは、タイミングが1つの言語向けに書かれていることです。英語の2行に収まるキューが、同じ数秒間、同じ映像の上で、4行を保持しなければならなくなります。そのため、このガイドの大部分は、マージ後に何を修正すべきかに割かれています。
12キューのテストファイルを作成し、スペイン語、中国語、アラビア語版を生成し、無料チェッカーを書きました。ファイルはBookTranslator自身の字幕書き出しコードをローカルで実行したものです。翻訳はモデルを呼び出さずに手作業で書いたため、これらのテストはファイルに何が起こるかを示すものであり、翻訳の品質を示すものではありません。詳細はREADMEにあります。チェッカーはPython 3のみが必要で、他には何も要りません。
簡単な答え:バイリンガルキューの見た目
2
00:00:03,400 --> 00:00:06,600
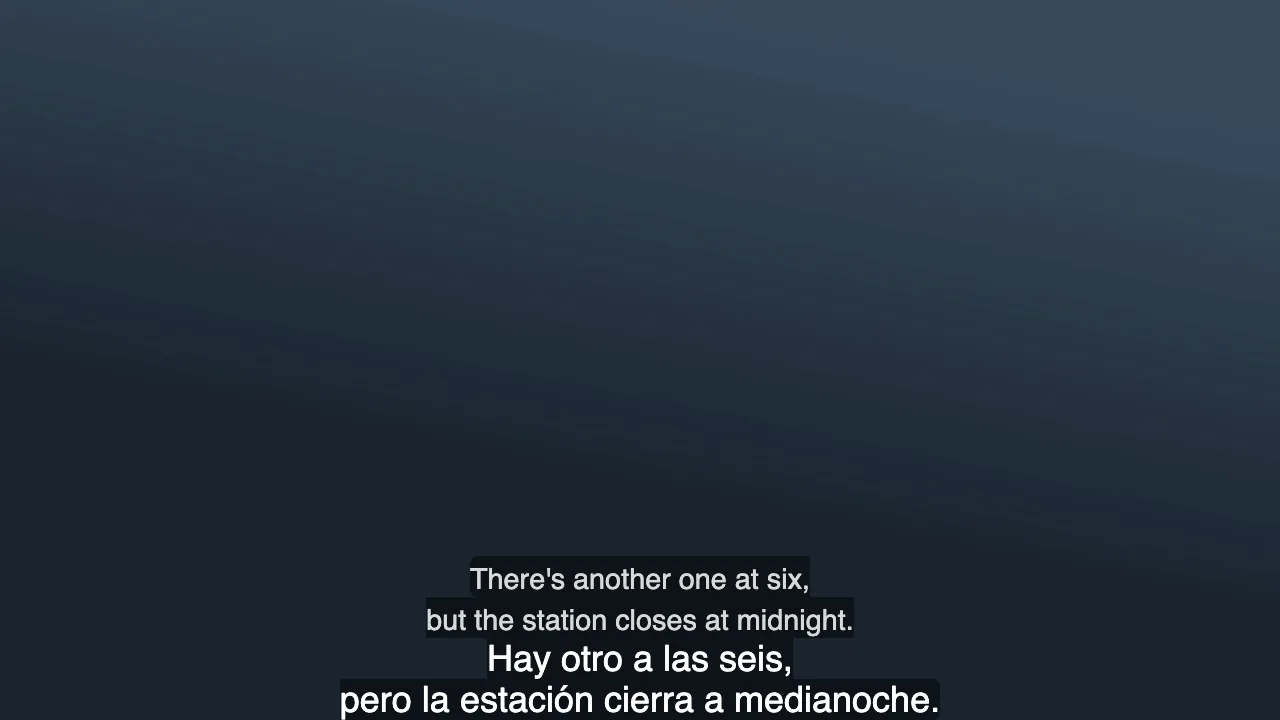
There's another one at six,
but the station closes at midnight.
Hay otro a las seis,
pero la estación cierra a medianoche.
これは有効なSRTです。各キューは番号とタイムスタンプを保持し、タイムスタンプの下のすべてのテキスト行が一緒に画面に表示されます。WebVTTも同じように機能します。
まず設定を選ぶ
| やりたいこと | 使用するもの | 理由 |
|---|---|---|
| ほぼどのプレーヤーでも視聴したい、または1つのファイルを誰かに送りたい | マージされた1つのSRT | 普通の字幕ファイル1つで、プレーヤーの機能は不要です |
| 自分のコンピューターで各言語をコントロールして視聴したい | 2トラック対応プレーヤーで2つの別ファイル | 各言語が独自のタイミングを保ち、移動やオフが可能です |
| ウェブページで言語を異なるサイズで表示したい | 各言語にクラスを付けた1つのVTT | WebVTTにはスタイリングがあり、SRTには標準的な方法がありません |
| どこでも同じ見た目になる動画を公開したい | 焼き込み字幕 | テキストが映像の一部になり、視聴者はオフにできません |
2トラックの場合、mpvには--secondary-sidオプションがあります。マニュアルによると、2番目のトラックはデフォルトで画面の上部に描画され、言語が分離されます。mpv自体はテストしていません。
焼き込みには、FFmpegのsubtitlesフィルターにlibassを含むビルドが必要です。このテスト用にインストールしたFFmpeg 9.0.1には含まれていなかったため、計画を立てる前にffmpeg -filters | grep subtitlesを実行してください。焼き込みはテストしていません。
ステップ1:2言語を1つのファイルに入れる
ファイルが1つある場合は、二言語ファイルを出力するツールで翻訳してください。BookTranslatorはすべてのSRTとVTTの処理でこれを行います。翻訳済みファイルと、同じタイムスタンプを持つバイリンガルファイルが得られ、字幕翻訳ツールから始められます。まずツールを選ぶ必要がある場合は、字幕ソフトウェア比較をご覧ください。
ファイルが2つある場合は、キュー番号ではなく時間でペアにしてください。同じ動画の2つのトラックは行の分割方法がほとんど同じにならないため、ここでマージがうまくいかなくなります。2番目のスペイン語トラックでは、長い2つのキューが半分に分割され、効果音、年、音楽が省略されています。
python3 check_bilingual_subs.py merge sample-source.srt sample-es-own-timing.srt -o merged.srt
キュー番号でペアにすると(スクリプトの--indexオプション)、12個のキューのうち10個が間違っていました。キュー2から始まり、スペイン語の半分が欠落しています。キュー3では、翻訳が別の行のものになっていました:
3
00:00:06,800 --> 00:00:08,000
So where do we wait?
pero la estación cierra a medianoche.
時間でペアにすると、正しい翻訳が9つのキューに収まり、スペイン語のない3つのキューはそのまま残り、何にも一致しなかったスペイン語の行が1つ報告されるので、手動で配置できます。スクリプトは、2番目のトラックのキューを、その長さの少なくとも半分をカバーする範囲で最も重なる1番目のトラックのキューに割り当てます。submergerなどのツールもファイルをマージしますが、テストはしていません。何を使うにしても、最初の分割以降のキューを抜き取り検査してください。
ステップ2:ファイルを確認する
python3 check_bilingual_subs.py check sample-source.srt sample-es-bilingual.srt --max-target-cps 17
バイリンガルファイルをソースと比較し、元の行が最初に来ることを前提としているので、順序を入れ替える前に実行してください。上部の行がソースと一致しない場合は警告が表示されます。スペイン語ファイルで見つかった内容は次のとおりです:
| キュー | 秒数 | 行数 | 原文の文字数/秒 | スペイン語の文字数/秒 | 問題 |
|---|---|---|---|---|---|
| 2 | 3.2 | 4 | 19.4 | 17.8 | 4行、スペイン語が速すぎる |
| 5 | 2.7 | 2 | 6.7 | 7.0 | テキスト内の' |
| 7 | 1.0 | 2 | 4.0 | 4.0 | 同じテキストが2回 |
| 8 | 1.8 | 2 | 1.7 | 1.7 | 同じテキストが2回 |
| 9 | 1.2 | 4 | 20.8 | 22.5 | 4行、両言語とも速すぎる |
| 10 | 3.6 | 2 | 18.3 | 19.4 | 両方の行が42文字超、スペイン語が速すぎる |
キュー6と12も4行で返ってきました。他の4つのキューは問題ありませんでした。
速度と行の長さの制限はNetflixのものです。その数値は公開されていて具体的であり、言語によって異なります。英語ガイドでは、成人向け番組で1行42文字、2行まで、1秒あたり最大20文字が許容されています。ラテンアメリカスペイン語ガイドでは翻訳字幕で1秒あたり17文字、簡体字中国語ガイドでは1行16文字、1秒あたり9文字が許容されています。したがって中国語には--max-target-line 16 --max-target-cps 9を使用してください。これらのガイドは一度に1言語、最大2行を対象としています。1つのキューに2言語を入れる場合の同等の標準は知らないため、チェッカーのデフォルトである画面上3行、および次のセクションのすべては私たちの判断です。
チェッカーは合計値も出力し、キュー9では1秒あたり43.3文字に達しました。その数値を修正しようとしないでください。両言語のすべての文字を集中して読む人はいません。注意すべきキューの目安として扱ってください。
ステップ3:4行のキューを修正する
4行にするとこれだけのコストがかかります。Chromiumの内蔵字幕表示を1280x720で見ると、2行の英語キューがフレームの高さの10.6%を占め、同じキューにスペイン語を加えると21.9%になりました。
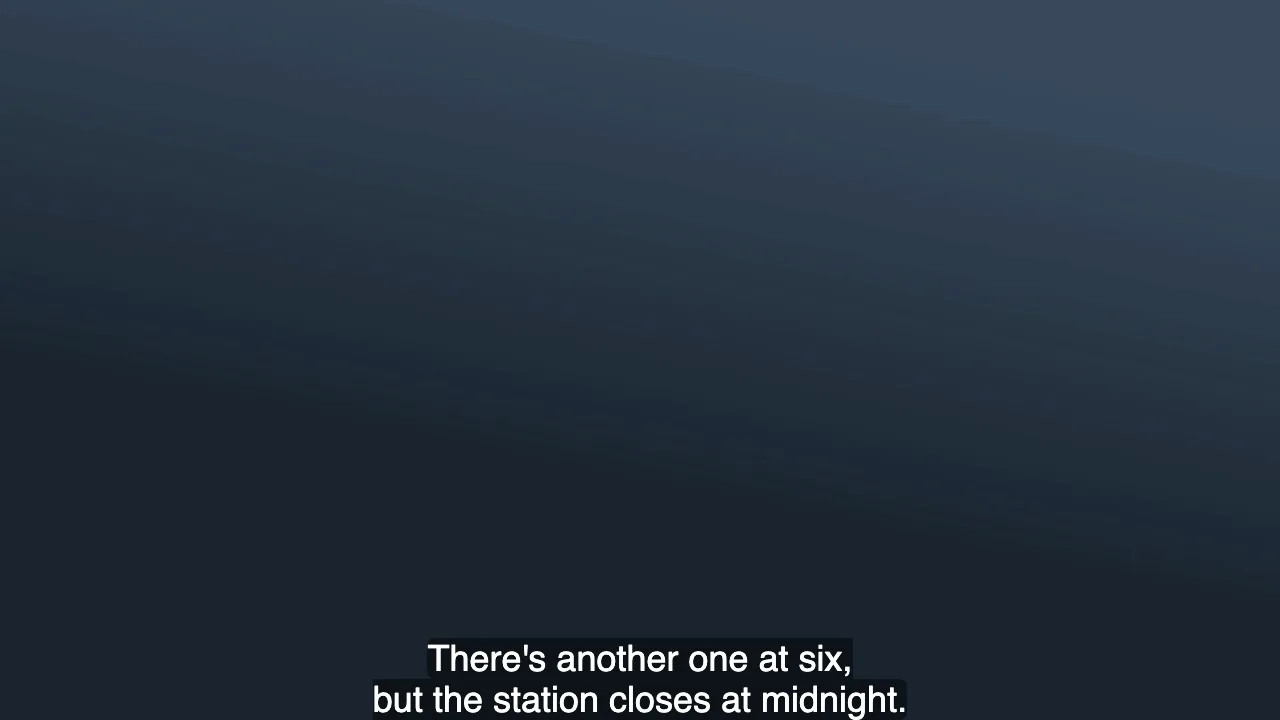
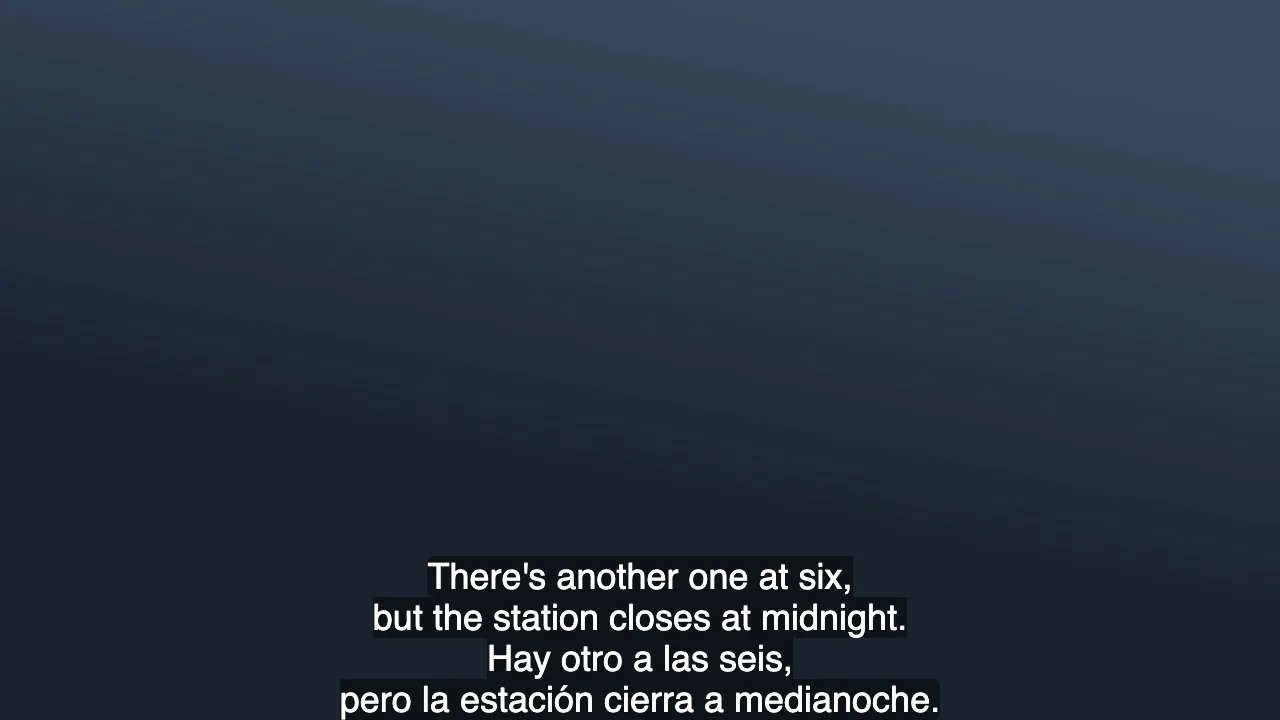
フラグが付いたキューは次の順番で対処します。
- 音声の言語は一言一句そのまま残す。 視聴者がオリジナル音声を聞きながらテキストを追っている場合、短縮したオリジナルはもはや聞こえる内容と一致しません。
- もう一方の言語を1行に削る。 キュー2は、スペイン語を
A las seis hay otro; cierran a medianoche.にすると、毎秒17.8文字から13.1文字になります。画面上は4行ではなく3行になり、両方の事実が保たれます。 - 余裕がある場合にのみ時間を追加する。 終了時間を動かす前に、次のキューの開始時間を確認してください。キュー2には0.2秒の余裕がありますが、手間をかける価値はありません。
- あとはそのままにする。 キュー9は
You knew?/Since March.で1.2秒です。速度と行数の制限に違反していますが、そのままにします。後ろの0.2秒の間隔は助けになるには短すぎ、視聴者は2つの短い返答を一目で把握できる可能性が高いからです。すべてのフラグがバグというわけではありません。
キュー10のような長い1行については、キューに時間の余裕がある場合に限り、各言語を2行に分割します。そうでなければ翻訳を短くします。
表示を制御できる場合は、一方の言語を区別しやすくすることもできます。to-vttを実行すると、各言語に独自のクラスが割り当てられます。生成されたファイルをChromiumでレンダリングし、英語を80%のサイズで薄いグレーにしました。これではほとんどスペースを節約できず(フレームの高さの21.9%ではなく21.1%)、行を削る代わりにはなりません。読解に役立つかどうかは検証していません。
これはWebVTTのキュークラスと::cue()セレクターを使用しています。ブラウザ向けの機能です。他のプレーヤーではスタイルやVTTファイルが無視される可能性があります。
ステップ4:どちらの言語を上に配置するかを決める
これについてはいくつかの研究があります。英語を第二言語とするスペイン語ネイティブ42人を対象とした2026年のアイトラッキング研究では、視聴者はどちらの言語であっても上の行により多くの時間を費やし、音声と一致する行により多くの時間を費やしました。理解度スコアは、第一言語であるスペイン語を上にした場合の方が高くなりました。英語を学ぶ中国語話者112人を対象とした以前の研究では、バイリンガル字幕は第一言語のみの字幕と同じくらい理解を助け、どちらも英語のキャプションや字幕なしよりも優れていました。
これらは特定の視聴者グループを対象とした単一の研究であるため、出発点として捉えてください。
- 映画や講義を内容理解のために追う場合: 最も読みやすい言語を上に配置します。
- 学習中の言語を練習する場合: その言語を上に配置し、理解度が多少下がることを受け入れます。2026年の研究が測定したのは理解度であり、学習効果ではないため、これは私たちの判断です。
- 翻訳をレビューする場合: 順序はほとんど重要ではないため、そのままにします。
BookTranslatorのバイリンガルファイルは常に原文を上に配置します。入れ替えるには:
python3 check_bilingual_subs.py flip sample-source.srt sample-es-bilingual.srt -o translation-on-top.srt
返ってくる内容の誤りとその修正方法
これらはテストファイルでBookTranslatorの字幕コードを実行した結果であり、チェッカーは最初の2つをフラグします。
- 翻訳不要なテキストが2回表示される。
1984や♪ ♪は翻訳する単語がないためスキップされますが、バイリンガルファイルではそれぞれ2回出力されます。1行を手動で削除してください。 - テキストに
'が現れることがある。 2026年11月現在、フォーマットタグとアポストロフィを含むキューは、アポストロフィがエスケープされて返ってくることがあります。元の行はバイリンガルファイルで<i>Don't answer that.</i>になり、別のVTTテストではフランス語翻訳が翻訳ファイルでも<i>Je n'attendrai pas.</i>になりました。ChromiumはVTTでこれをデコードし、通常のアポストロフィを表示しました。しかし、FFmpegでSRTに変換したところ、'が出力テキストに残ったため、一部のプレーヤーではそのまま表示されると想定してください。ファイルを使用する前に'を'に置き換えてください。この問題はエンジニアに報告済みです。 - VTTキューの設定が削除される。
line:0 align:start position:10%のような位置設定やNOTEブロックがVTTテスト出力から消え、話者ラベルが両方の行に表示されました。VTTが配置に依存している場合は、翻訳後に設定を追加し直してください。 - 右から左に書く言語のテキストは行ごとにマークされます。 アラビア語の行はUnicodeの方向マークで囲まれて返ってきました。ChromiumでファイルのVTTコピーにある1つのキューだけを確認したところ、右から左に表示されました。アラビア語と数字が混在する行(キュー10など)はより難しいケースで、これらは確認していないため、実際にお使いのプレーヤーでテストしてください。SRTには方向を設定する他の方法がありません。書籍全般に関するより広い問題については、右から左への翻訳ガイドで解説しています。
ソースがASSまたはSSAの場合、BookTranslatorのバイリンガル出力は、翻訳された行を同じスタイルとタイミングの2番目のイベントとして追加します。これは異なる構造です。これらのファイルがどのように構成されているかは、ASS字幕ガイドで説明しています。どちらの言語でもアクセント付き文字が壊れて見える場合、問題は通常ファイルのエンコーディングです。これについては字幕エンコーディングガイドで扱っています。
ファイルを共有する前に
- チェッカーを実行し、フラグが付いたすべてのキューを確認します。
'、&、"を見つけて置き換えます。- 効果音、数字、音楽に関する重複行を削除します。
- 視聴者が使うプレーヤーで、視聴者が使う画面サイズで、最も混み合う数分間を視聴します。
- 下部の行がビデオ内のオンスクリーンテキストを覆っていないことを確認します。
- 翻訳を文脈の中で読みます。レビューの方法については、AI字幕ワークフローで解説しています。
SRTまたはVTTの準備はできましたか?字幕翻訳ツールにアップロードして、支払い前に価格を確認してください。完了したら、バイリンガルファイルと翻訳済みファイルをダウンロードします。実際のジョブでは行数がモデルによる各翻訳キューの分割方法に依存するため、その後でチェッカーを実行してください。