Hoe maak je tweetalige ondertitels: twee talen in één SRT- of VTT-bestand
Maak een tweetalig SRT- of VTT-bestand dat leesbaar is: voeg samen op tijd, pas twee talen in één cue, kies welke bovenaan staat en gebruik een gratis checker.
Om tweetalige ondertitels te maken heb je één getimed ondertitelbestand nodig, een vertaling daarvan met dezelfde timing, en één cue per moment dat beide talen bevat: eerst de originele regels, dan de vertaalde regels, onder één tijdstempel. Elke vertaler die een dubbel bestand schrijft, doet dit voor je, en een samenvoegtool doet het als je al twee bestanden hebt. Gewone SRT heeft geen speciale syntax nodig.
Het bestand maken is het makkelijke deel. Het moeilijkere deel is dat de timing voor één taal is geschreven. Een cue die twee regels Engels bevat, moet nu vier regels bevatten, in dezelfde paar seconden, over hetzelfde beeld. Daarom besteedt deze gids de meeste tijd aan wat je na het samenvoegen moet oplossen.
We schreven een testbestand met 12 cues, maakten Spaanse, Chinese en Arabische versies, en schreven een gratis checker. De bestanden komen uit BookTranslators eigen code voor het schrijven van ondertitels, lokaal uitgevoerd. We schreven de vertalingen met de hand in plaats van een model aan te roepen, dus deze tests laten zien wat er met het bestand gebeurt, niet hoe goed een vertaling is. De README bevat de details. De checker heeft alleen Python 3 nodig.
Snel antwoord: hoe een tweetalige cue eruitziet
2
00:00:03,400 --> 00:00:06,600
There's another one at six,
but the station closes at midnight.
Hay otro a las seis,
pero la estación cierra a medianoche.
Dat is geldige SRT. Elke cue behoudt zijn nummer en tijdstempel, en elke regel tekst onder de tijdstempel verschijnt tegelijk op het scherm. WebVTT werkt op dezelfde manier.
Kies eerst de opzet
| Je wilt | Gebruik | Waarom |
|---|---|---|
| Kijken in bijna elke speler, of één bestand naar iemand sturen | Eén samengevoegd SRT-bestand | Het is één gewoon ondertitelbestand, zonder speciale spelerfunctie |
| Op je eigen computer kijken met controle over elke taal | Twee aparte bestanden in een speler met ondersteuning voor twee sporen | Elke taal behoudt zijn eigen timing en kan worden verplaatst of uitgeschakeld |
| De talen in verschillende groottes op een webpagina tonen | Eén VTT met een class voor elke taal | WebVTT heeft styling; SRT heeft geen standaardmanier om dit te doen |
| Een video publiceren die er overal hetzelfde uitziet | Ingebrande ondertitels | De tekst wordt deel van het beeld en kijkers kunnen hem niet uitzetten |
Voor twee sporen heeft mpv een --secondary-sid-optie. Volgens de handleiding wordt het tweede spoor standaard bovenaan het scherm getekend, waardoor de talen gescheiden blijven. We hebben mpv niet zelf getest.
Voor het inbranden heeft FFmpeg's subtitles-filter een build met libass nodig. De FFmpeg 9.0.1 die we voor deze test hebben geïnstalleerd, had dat niet, dus voer ffmpeg -filters | grep subtitles uit voordat je erop rekent. We hebben inbranden niet getest.
Stap 1: Twee talen in één bestand krijgen
Als je één bestand hebt, vertaal het dan met een tool die een dubbel bestand schrijft. BookTranslator doet dit voor elke SRT- en VTT-taak: je krijgt een vertaald bestand en een tweetalig bestand met dezelfde tijdstempels, en je kunt beginnen bij de ondertitelvertaler. Als je eerst een tool moet kiezen, zie onze vergelijking van ondertitelsoftware.
Als je twee bestanden hebt, koppel ze dan op tijd, niet op cue-nummer. Hier gaat het samenvoegen vaak mis, omdat twee sporen van dezelfde video hun regels zelden op dezelfde manier splitsen. Ons tweede Spaanse spoor splitst twee lange cues in tweeën en laat het geluidseffect, het jaar en de muziek weg.
python3 check_bilingual_subs.py merge sample-source.srt sample-es-own-timing.srt -o merged.srt
Koppelen op cue-nummer (de --index-optie van het script) had 10 van de 12 cues fout, te beginnen bij cue 2, waar de helft van het Spaans ontbrak. Bij cue 3 hoorde de vertaling bij een andere regel:
3
00:00:06,800 --> 00:00:08,000
So where do we wait?
pero la estación cierra a medianoche.
Koppelen op tijd gaf de juiste vertaling onder 9 cues, liet de 3 cues zonder Spaans met rust en meldde de ene Spaanse regel die nergens bij hoorde, zodat je die handmatig kunt plaatsen. Het script kent een cue uit het tweede spoor toe aan de cue uit het eerste spoor die er het meest mee overlapt, zolang die overlap ten minste de helft van de lengte beslaat. Tools zoals submerger voegen ook bestanden samen; we hebben ze niet getest. Wat je ook gebruikt, controleer de cues na de eerste splitsing.
Stap 2: Controleer het bestand
python3 check_bilingual_subs.py check sample-source.srt sample-es-bilingual.srt --max-target-cps 17
Het vergelijkt het tweetalige bestand met de bron en gaat ervan uit dat de originele regels bovenaan staan, dus voer het uit voordat je de volgorde omwisselt. Het waarschuwt je als de bovenste regels niet overeenkomen met de bron. Dit is wat het in het Spaanse bestand vond:
| Cue | Seconden | Regels | Originele tekens/sec | Spaanse tekens/sec | Probleem |
|---|---|---|---|---|---|
| 2 | 3.2 | 4 | 19.4 | 17.8 | Vier regels, Spaans te snel |
| 5 | 2.7 | 2 | 6.7 | 7.0 | ' in de tekst |
| 7 | 1.0 | 2 | 4.0 | 4.0 | Zelfde tekst twee keer |
| 8 | 1.8 | 2 | 1.7 | 1.7 | Zelfde tekst twee keer |
| 9 | 1.2 | 4 | 20.8 | 22.5 | Vier regels, beide talen te snel |
| 10 | 3.6 | 2 | 18.3 | 19.4 | Beide regels meer dan 42 tekens, Spaans te snel |
Cues 6 en 12 kwamen ook terug met vier regels. De andere vier cues waren in orde.
De snelheids- en regellengtelimieten komen van Netflix, omdat de cijfers openbaar en specifiek zijn en per taal verschillen. De Engelse gids staat 42 tekens per regel toe, twee regels, en tot 20 tekens per seconde voor volwassenenprogramma's. De Latijns-Amerikaans Spaanse gids staat 17 tekens per seconde toe voor vertaalde ondertitels, en de Vereenvoudigd Chinese gids staat 16 tekens per regel en 9 per seconde toe. Gebruik dus --max-target-line 16 --max-target-cps 9 voor Chinees. Die gidsen behandelen één taal tegelijk, met maximaal twee regels. We kennen geen gelijkwaardige standaard voor twee talen in één cue, dus de standaard van de checker van drie regels op het scherm, en alles in de volgende sectie, is onze eigen inschatting.
De checker drukt ook een gecombineerd getal af, dat op cue 9 43,3 tekens per seconde bereikte. Probeer dat getal niet te repareren. Niemand leest elk teken van beide talen met volledige aandacht. Zie het als een aanwijzing voor de cues die het bekijken waard zijn.
Stap 3: Los de cues met vier regels op
Dit is wat vier regels kosten. In de ingebouwde ondertitelweergave van Chromium op 1280x720 nam de tweeregelige Engelse cue 10,6% van de framehoogte in, en dezelfde cue met Spaans erbij 21,9%.
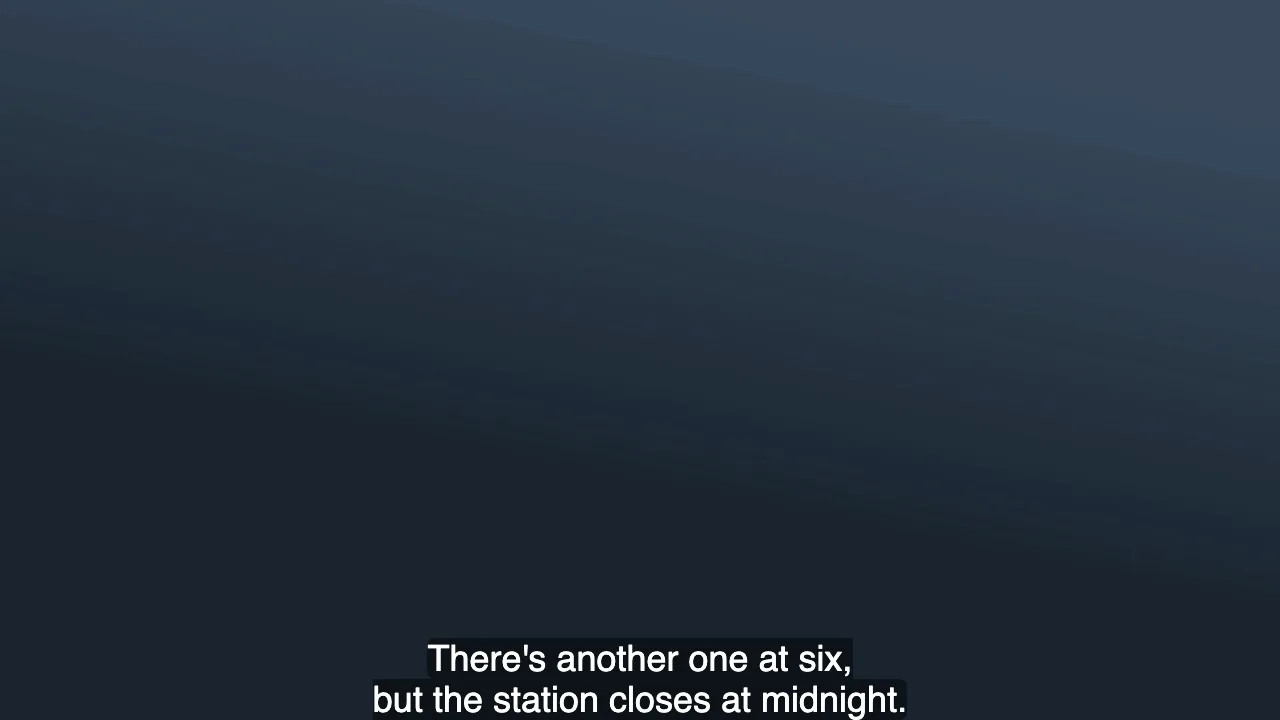
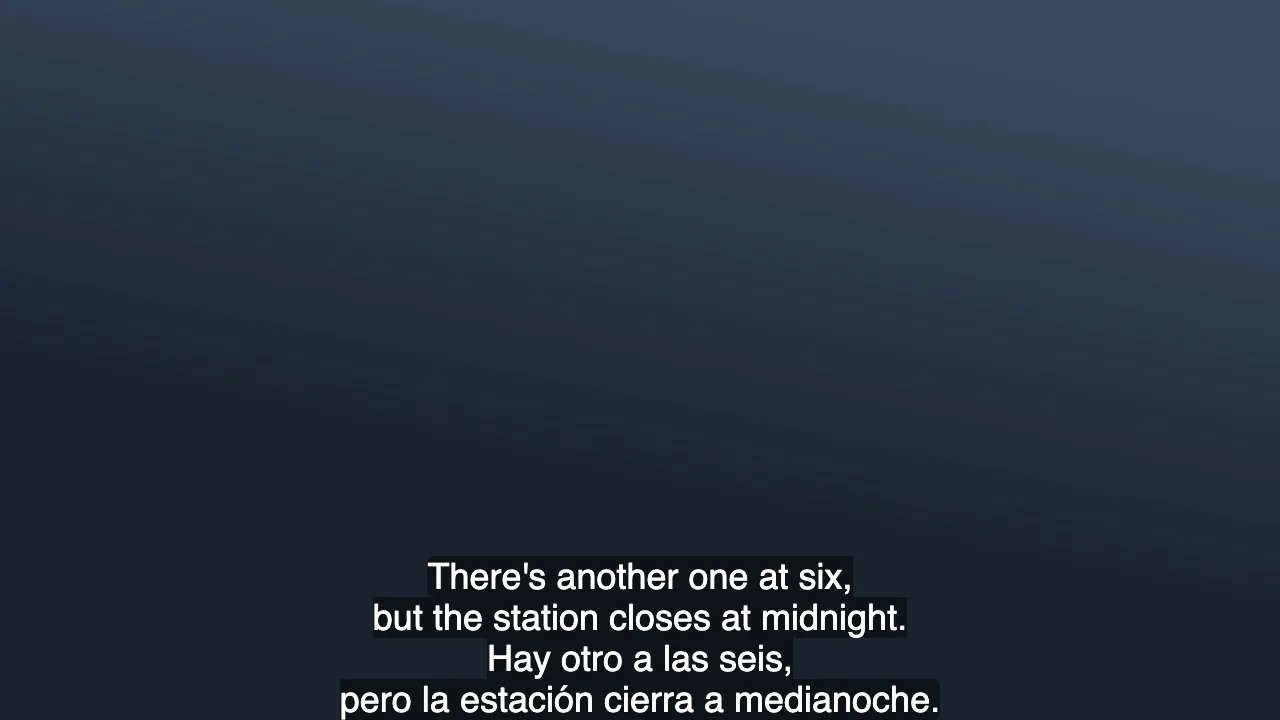
Loop de gemarkeerde cues in deze volgorde na:
- Houd de audiotaal woord voor woord. Als mensen naar het origineel luisteren en meelezen, past een verkort origineel niet meer bij wat ze horen.
- Beperk de andere taal tot één regel. Onze cue 2 gaat van 17,8 naar 13,1 tekens per seconde wanneer het Spaans
A las seis hay otro; cierran a medianoche.wordt. Dat zijn drie regels op het scherm in plaats van vier, en beide feiten blijven behouden. - Voeg alleen tijd toe als er een gat is. Controleer de start van de volgende cue voordat je een eindtijd verschuift. Cue 2 heeft 0,2 seconde over, wat de moeite niet loont.
- Laat de rest dan met rust. Cue 9 is
You knew?/Since March.in 1,2 seconden. Het overschrijdt de snelheids- en regellimieten, maar we zouden het laten staan: de opening van 0,2 seconde erna is te klein om te helpen, en een kijker kan waarschijnlijk twee korte antwoorden in één oogopslag bevatten. Niet elke markering is een fout.
Breek lange enkele regels zoals cue 10 alleen in twee regels per taal als de cue de tijd ervoor heeft. Verkort anders de vertaling.
Als je de weergave beheert, kun je ook één taal gemakkelijker herkenbaar maken. Voer to-vtt uit om elke taal een eigen class te geven. Het resulterende bestand werd in Chromium weergegeven met het Engels op 80% grootte en in lichtgrijs. Dit bespaart nauwelijks ruimte (21,1% van de framehoogte in plaats van 21,9%), dus het is geen vervanging voor het inkorten van een regel. We hebben niet getest of het mensen helpt bij het lezen.
Dit gebruikt WebVTT cue-classes en de ::cue()-selector. Het is bedoeld voor browsers. Andere spelers negeren de stijlen of het VTT-bestand mogelijk.
Stap 4: Bepaal welke taal bovenaan komt
Er is enig onderzoek hiernaar. In een eye-trackingonderzoek uit 2026 onder 42 moedertaalsprekers van het Spaans met Engels als tweede taal, besteedden kijkers meer tijd aan de bovenste regel, ongeacht welke taal daarin stond, en ze besteedden meer tijd aan de regel die overeenkwam met de audio. De begripscores waren hoger met Spaans, hun eerste taal, bovenaan. Een eerder onderzoek onder 112 Chinese leerders van het Engels vond dat tweetalige ondertitels het begrip evenveel hielpen als ondertitels in alleen hun eerste taal, en beide beter waren dan Engelse ondertitels of geen ondertitels.
Dit zijn afzonderlijke onderzoeken onder specifieke groepen kijkers, dus beschouw ze als uitgangspunt:
- Een film of lezing volgen om de inhoud: zet de taal die je het beste leest bovenaan.
- Een taal oefenen die je leert: zet die taal bovenaan en accepteer dat je mogelijk iets minder begrijpt. Begrip is wat het onderzoek uit 2026 mat, niet leren, dus dit is onze inschatting.
- Een vertaling beoordelen: de volgorde maakt weinig uit, dus laat het zo.
Het tweetalige bestand van BookTranslator zet altijd het origineel bovenaan. Om dit om te wisselen:
python3 check_bilingual_subs.py flip sample-source.srt sample-es-bilingual.srt -o translation-on-top.srt
Wat er fout terugkomt, en hoe je het oplost
Deze kwamen uit het draaien van BookTranslator's ondertitelcode op onze testbestanden, en de checker markeert de eerste twee.
- Tekst die geen vertaling nodig heeft, verschijnt twee keer.
1984en♪ ♪worden overgeslagen omdat er geen woorden te vertalen zijn, dus het tweetalige bestand drukt elk ervan twee keer af. Verwijder één regel handmatig. 'kan in de tekst verschijnen. Sinds november 2026 kan een cue met opmaaktags en een apostrof terugkomen met de apostrof geëscaped. Onze oorspronkelijke regel werd<i>Don't answer that.</i>in het tweetalige bestand, en in een aparte VTT-test werd een Franse vertaling<i>Je n'attendrai pas.</i>in het vertaalde bestand ook. Chromium decodeerde het in VTT en toonde een normale apostrof. Maar toen we de SRT met FFmpeg converteerden, bleef de'in de uitvoertekst staan, dus ga ervan uit dat sommige spelers het letterlijk weergeven. Vervang'door'voordat je het bestand gebruikt. We hebben dit gemeld bij onze engineers.- VTT-cue-instellingen worden verwijderd. Positie-instellingen zoals
line:0 align:start position:10%enNOTE-blokken waren verdwenen uit onze VTT-testuitvoer, en sprekerlabels verschenen op beide regels. Als je VTT afhankelijk is van plaatsing, voeg die dan opnieuw toe na het vertalen. - Rechts-naar-links tekst wordt regel voor regel gemarkeerd. Arabische regels kwamen terug met Unicode-richtingstekens eromheen. We hebben slechts één cue bekeken, in een VTT-kopie van het bestand in Chromium, en die werd rechts-naar-links weergegeven. Regels die Arabisch met cijfers mengen, zoals onze cue 10, zijn het lastigere geval en die hebben we niet bekeken, dus test in je eigen speler. SRT heeft geen andere manier om de richting in te stellen. Onze handleiding voor rechts-naar-links behandelt de bredere problemen voor boeken.
Als je bron ASS of SSA is, voegt de tweetalige uitvoer van BookTranslator de vertaalde regel toe als een tweede event met dezelfde stijl en timing, wat een andere structuur is. Onze ASS-ondertitelhandleiding legt uit hoe die bestanden in elkaar zitten. Als geaccentueerde tekens in een van beide talen kapot lijken, is het probleem meestal de codering van het bestand, wat onze handleiding voor ondertitelcodering behandelt.
Voordat je het bestand deelt
- Voer de checker uit en loop elke gemarkeerde cue na.
- Zoek
',&en"en vervang ze. - Verwijder dubbele regels bij geluidseffecten, cijfers en muziek.
- Bekijk de drukste paar minuten in de speler die je kijkers gebruiken, op de schermgrootte die zij gebruiken.
- Controleer of de onderste regels geen tekst in de video bedekken.
- Lees de vertaling in context. Onze AI-ondertitelworkflow behandelt hoe je die kunt beoordelen.
Heb je een SRT of VTT klaar? Upload het naar de ondertitelvertaler en bekijk de prijs voordat je betaalt. Als het klaar is, download je het tweetalige bestand samen met het vertaalde bestand. Voer daarna de checker erop uit, want het aantal regels in een echte opdracht hangt af van hoe het model elke vertaalde cue opsplitst.
Gerelateerde berichten