Como criar legendas bilingues: duas línguas num único ficheiro SRT ou VTT
Crie um ficheiro SRT ou VTT bilingue que as pessoas consigam ler: combine por tempo, encaixe duas línguas numa única entrada, escolha qual fica em cima e execute um verificador gratuito.
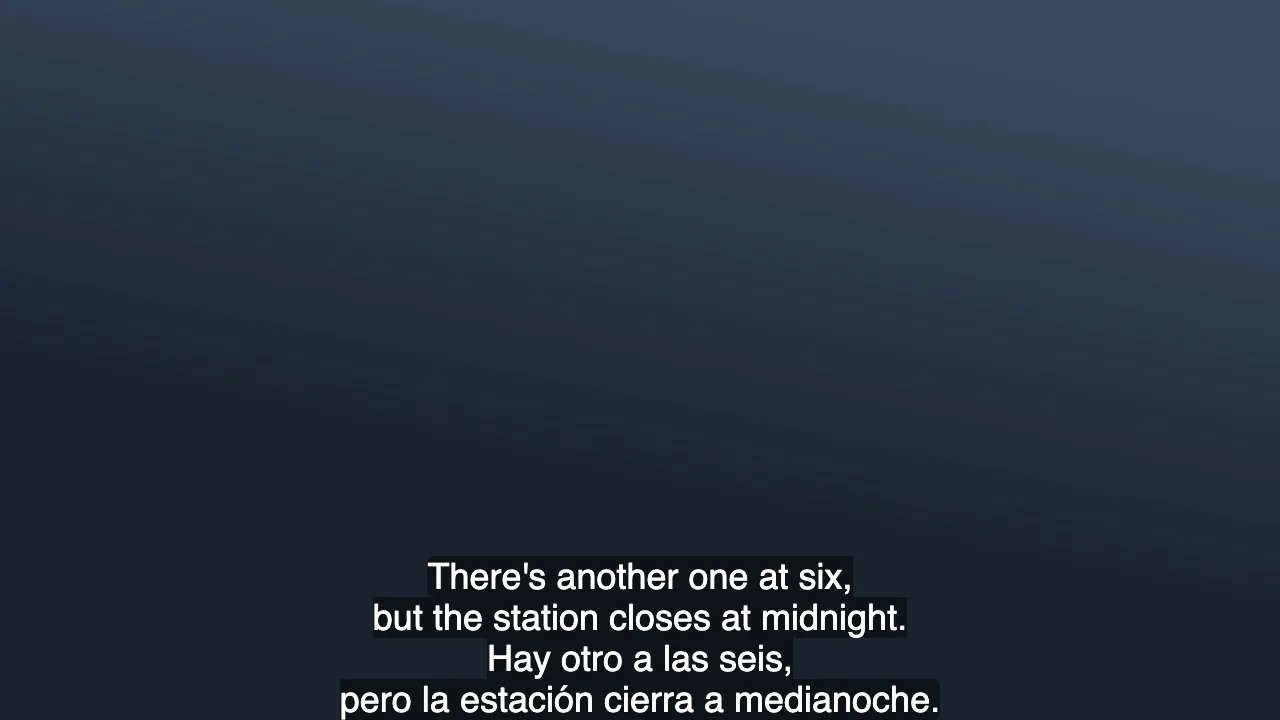
Para criar legendas bilingues, precisa de um ficheiro de legendas com tempos, de uma tradução desse ficheiro que mantenha os mesmos tempos e de uma entrada para cada momento que contenha ambas as línguas: primeiro as linhas originais, depois as linhas traduzidas, sob um único timestamp. Qualquer tradutor que escreva um ficheiro duplo faz isto por si, e uma ferramenta de combinação faz o mesmo se já tiver dois ficheiros. O SRT simples não precisa de sintaxe especial para isto.
Criar o ficheiro é a parte fácil. A parte mais difícil é que os tempos foram escritos para uma língua. Uma entrada que comporta duas linhas de inglês tem agora de conter quatro linhas, nos mesmos poucos segundos, sobre a mesma imagem. Por isso, este guia dedica a maior parte do tempo ao que corrigir depois da combinação.
Criámos um ficheiro de teste com 12 entradas, produzimos versões em espanhol, chinês e árabe e escrevemos um verificador gratuito. Os ficheiros vieram do próprio código de escrita de legendas do BookTranslator, executado localmente. Escrevemos as traduções à mão em vez de recorrer a um modelo, pelo que estes testes mostram o que acontece ao ficheiro, não a qualidade da tradução. O README tem os detalhes. O verificador precisa de Python 3 e de mais nada.
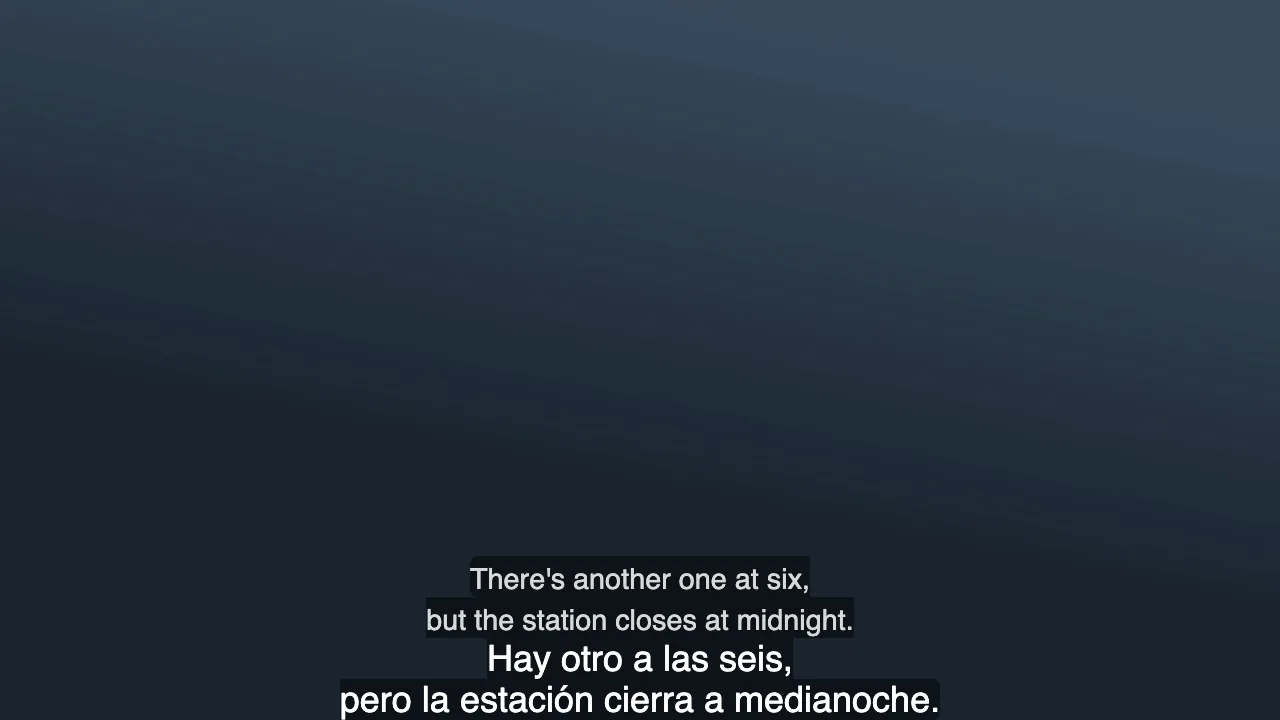
Resposta rápida: como é uma entrada bilingue
2
00:00:03,400 --> 00:00:06,600
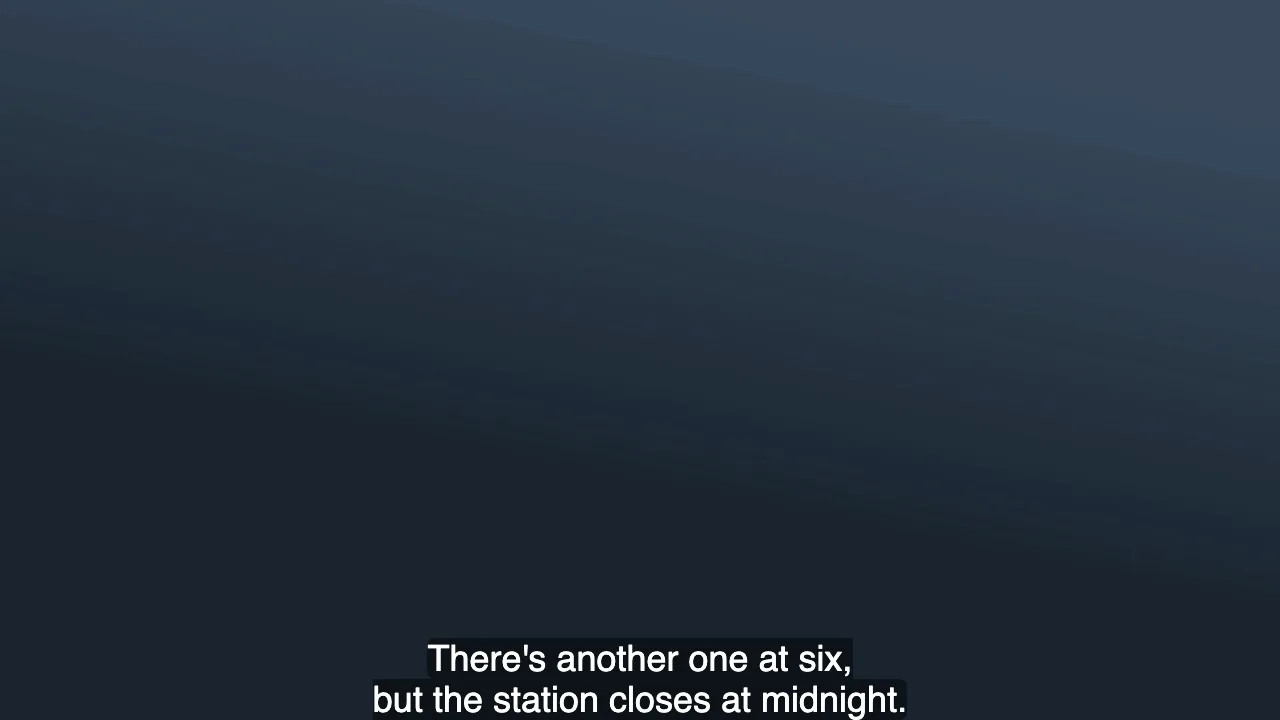
There's another one at six,
but the station closes at midnight.
Hay otro a las seis,
pero la estación cierra a medianoche.
Isto é SRT válido. Cada entrada mantém o seu número e timestamp, e todas as linhas de texto abaixo do timestamp aparecem no ecrã em conjunto. O WebVTT funciona da mesma forma.
Escolha primeiro a configuração
| Pretende | Utilize | Porquê |
|---|---|---|
| Ver em quase qualquer leitor ou enviar um único ficheiro a alguém | Um SRT combinado | É um ficheiro de legendas comum, sem necessidade de funcionalidades do leitor |
| Ver no seu próprio computador com controlo sobre cada língua | Dois ficheiros separados num leitor com suporte para duas faixas | Cada língua mantém os seus próprios tempos e pode ser movida ou desativada |
| Mostrar as línguas com tamanhos diferentes numa página web | Um VTT com uma classe para cada língua | O WebVTT tem estilos; o SRT não tem forma padrão de o fazer |
| Publicar um vídeo que fique igual em todo o lado | Legendas incorporadas no vídeo | O texto passa a fazer parte da imagem e os espetadores não o podem desativar |
Para duas faixas, o mpv tem uma opção --secondary-sid. O manual indica que a segunda faixa é desenhada no topo do ecrã por predefinição, o que mantém as línguas separadas. Não testámos o mpv.
Para a gravação permanente, o filtro de legendas do FFmpeg precisa de uma compilação com libass. O FFmpeg 9.0.1 que instalámos para este teste não a tinha, por isso execute ffmpeg -filters | grep subtitles antes de planear em torno disso. Não testámos a gravação permanente.
Passo 1: Colocar duas línguas num só ficheiro
Se tiver um ficheiro, traduza-o com uma ferramenta que escreva um ficheiro duplo. O BookTranslator faz isto para todos os trabalhos SRT e VTT: obtém um ficheiro traduzido e um ficheiro bilingue com as mesmas marcas temporais, e pode começar no tradutor de legendas. Se precisar de escolher primeiro uma ferramenta, consulte a nossa comparação de software de legendas.
Se tiver dois ficheiros, emparelhe-os por tempo, não por número de entrada. É aqui que a fusão corre mal, porque duas faixas do mesmo vídeo raramente dividem as linhas da mesma forma. A nossa segunda faixa em espanhol divide duas entradas longas ao meio e omite o efeito sonoro, o ano e a música.
python3 check_bilingual_subs.py merge sample-source.srt sample-es-own-timing.srt -o merged.srt
O emparelhamento por número de entrada (a opção --index do script) errou 10 das 12 entradas, começando na entrada 2, onde metade do espanhol desapareceu. Na entrada 3, a tradução pertencia a uma linha diferente:
3
00:00:06,800 --> 00:00:08,000
So where do we wait?
pero la estación cierra a medianoche.
O emparelhamento por tempo deu a tradução correta em menos de 9 entradas, deixou as 3 entradas sem espanhol em paz e reportou a única linha em espanhol que não correspondia a nada, para que a possa colocar à mão. O script atribui uma entrada da segunda faixa à entrada da primeira faixa com que se sobrepõe mais, desde que essa sobreposição cubra pelo menos metade do seu comprimento. Ferramentas como o submerger também fundem ficheiros; não as testámos. Seja o que for que usar, verifique por amostragem as entradas após a primeira divisão.
Passo 2: Verificar o ficheiro
python3 check_bilingual_subs.py check sample-source.srt sample-es-bilingual.srt --max-target-cps 17
Compara o ficheiro bilingue com a fonte e assume que as linhas originais vêm primeiro, por isso execute-o antes de trocar a ordem. Avisa-o se as linhas de cima não corresponderem à fonte. Isto foi o que encontrou no ficheiro em espanhol:
| Entrada | Segundos | Linhas | Caracteres/seg original | Caracteres/seg espanhol | Problema |
|---|---|---|---|---|---|
| 2 | 3.2 | 4 | 19.4 | 17.8 | Quatro linhas, espanhol demasiado rápido |
| 5 | 2.7 | 2 | 6.7 | 7.0 | ' no texto |
| 7 | 1.0 | 2 | 4.0 | 4.0 | Mesmo texto duas vezes |
| 8 | 1.8 | 2 | 1.7 | 1.7 | Mesmo texto duas vezes |
| 9 | 1.2 | 4 | 20.8 | 22.5 | Quatro linhas, ambas as línguas demasiado rápidas |
| 10 | 3.6 | 2 | 18.3 | 19.4 | Ambas as linhas com mais de 42 caracteres, espanhol demasiado rápido |
As entradas 6 e 12 também vieram com quatro linhas. As outras quatro entradas estavam bem.
Os limites de velocidade e de comprimento de linha vêm da Netflix, porque os seus números são públicos e específicos, e variam consoante a língua. O seu guia para inglês permite 42 caracteres por linha, duas linhas e até 20 caracteres por segundo para programas para adultos. O seu guia para espanhol latino-americano permite 17 caracteres por segundo para legendas traduzidas, e o seu guia para chinês simplificado permite 16 caracteres por linha e 9 por segundo. Por isso, use --max-target-line 16 --max-target-cps 9 para chinês. Esses guias abrangem uma língua de cada vez, com duas linhas no máximo. Não conhecemos nenhum padrão equivalente para duas línguas numa só entrada, por isso o padrão do verificador de três linhas no ecrã, e tudo na secção seguinte, é o nosso critério.
O verificador também imprime um número combinado, que atingiu 43,3 caracteres por segundo na entrada 9. Não tente corrigir esse número. Ninguém lê todos os caracteres de ambas as línguas com total atenção. Trate-o como um indicador das entradas que vale a pena observar.
Passo 3: Corrigir as entradas de quatro linhas
É este o custo de quatro linhas. Na apresentação de subtítulos integrada do Chromium a 1280x720, a legenda inglesa de duas linhas ocupava 10,6% da altura do ecrã, e a mesma legenda com espanhol acrescentado ocupava 21,9%.
Percorra as legendas sinalizadas por esta ordem:
- Mantenha a língua do áudio palavra por palavra. Se as pessoas estão a ouvir o original e a acompanhar pelo texto, um original encurtado deixa de corresponder ao que ouvem.
- Reduza a outra língua a uma linha. A nossa legenda 2 passa de 17,8 caracteres por segundo para 13,1 quando o espanhol fica
A las seis hay otro; cierran a medianoche.São três linhas no ecrã em vez de quatro, e mantém ambos os factos. - Só acrescente tempo se houver uma pausa. Verifique o início da legenda seguinte antes de alterar um tempo de fim. A legenda 2 tem 0,2 segundos de folga, o que não compensa o esforço.
- Depois, deixe o resto em paz. A legenda 9 é
You knew?/Since March.em 1,2 segundos. Viola os limites de velocidade e de linhas, mas deixá-la-íamos: a pausa de 0,2 segundos a seguir é demasiado pequena para ajudar, e é provável que o espetador consiga captar duas respostas curtas de relance. Nem todos os avisos são erros.
Para linhas únicas longas como a legenda 10, divida cada língua em duas linhas apenas se a legenda tiver tempo para isso. Caso contrário, encurte a tradução.
Se controlar a apresentação, também pode tornar uma das línguas mais fácil de distinguir. Execute to-vtt para dar a cada língua a sua própria classe. O ficheiro resultante foi renderizado no Chromium com o inglês a 80% do tamanho e em cinzento-claro. Isto poupa muito pouco espaço (21,1% da altura do ecrã em vez de 21,9%), pelo que não substitui o corte de uma linha. Não testámos se ajuda as pessoas a ler.
Isto utiliza classes de legendas WebVTT e o seletor ::cue(). Destina-se a navegadores. Outros leitores podem ignorar os estilos ou o ficheiro VTT.
Passo 4: Decidir qual língua fica em cima
Há alguma investigação sobre isto. Num estudo de rastreamento ocular de 2026 com 42 falantes nativos de espanhol com inglês como segunda língua, os espetadores passaram mais tempo na linha de cima, independentemente da língua em que estava, e passaram mais tempo na linha que correspondia ao áudio. As pontuações de compreensão foram mais altas com o espanhol, a sua primeira língua, em cima. Um estudo anterior com 112 aprendentes chineses de inglês concluiu que as legendas bilingues ajudavam a compreensão tanto como as legendas apenas na sua primeira língua, e ambas superavam as legendas em inglês ou a ausência de legendas.
São estudos isolados de grupos específicos de espetadores, por isso encare-os como um ponto de partida:
- Acompanhar um filme ou uma palestra pelo conteúdo: coloque em cima a língua que lê melhor.
- Praticar uma língua que está a aprender: coloque essa língua em cima e aceite que pode compreender um pouco menos. A compreensão é o que o estudo de 2026 mediu, não a aprendizagem, por isso esta é a nossa opinião.
- Rever uma tradução: a ordem importa pouco, por isso deixe-a como está.
O ficheiro bilingue do BookTranslator coloca sempre o original em cima. Para trocar:
python3 check_bilingual_subs.py flip sample-source.srt sample-es-bilingual.srt -o translation-on-top.srt
O que volta errado, e como corrigir
Estes casos resultaram de executar o código de subtítulos do BookTranslator nos nossos ficheiros de teste, e o verificador sinaliza os dois primeiros.
- Texto que não precisa de tradução aparece duas vezes.
1984e♪ ♪são ignorados por não terem palavras para traduzir, pelo que o ficheiro bilingue imprime cada um duas vezes. Elimine uma linha à mão. 'pode aparecer no texto. A partir de novembro de 2026, uma legenda com etiquetas de formatação e um apóstrofo pode voltar com o apóstrofo escapado. A nossa linha original tornou-se<i>Don't answer that.</i>no ficheiro bilingue, e num teste VTT separado uma tradução francesa tornou-se<i>Je n'attendrai pas.</i>também no ficheiro traduzido. O Chromium descodificou-o em VTT e mostrou um apóstrofo normal. Mas quando convertemos o SRT com o FFmpeg, o'permaneceu no texto de saída, por isso assuma que alguns leitores o mostrarão literalmente. Substitua'por'antes de utilizar o ficheiro. Comunicámos isto aos nossos engenheiros.- As definições de legendas VTT são removidas. Definições de posição como
line:0 align:start position:10%e blocosNOTEdesapareceram do nosso resultado de teste VTT, e as etiquetas de orador apareceram em ambas as linhas. Se o seu VTT depende do posicionamento, volte a adicioná-lo depois de traduzir. - O texto da direita para a esquerda é marcado linha a linha. As linhas em árabe vieram envolvidas em marcas de direção Unicode. Analisámos apenas uma legenda, numa cópia VTT do ficheiro no Chromium, e era apresentada da direita para a esquerda. As linhas que misturam árabe com números, como a nossa legenda 10, são o caso mais difícil e não as visualizámos, por isso teste no seu leitor habitual. O SRT não tem outra forma de definir a direção. O nosso guia para texto da direita para a esquerda aborda as questões mais amplas dos livros.
Se a sua fonte for ASS ou SSA, a saída bilingue do BookTranslator adiciona a linha traduzida como um segundo evento com o mesmo estilo e temporização, o que constitui uma estrutura diferente. O nosso guia de legendas ASS explica como esses ficheiros são construídos. Se os caracteres acentuados aparecerem corrompidos em qualquer das línguas, o problema é normalmente a codificação do ficheiro, que o nosso guia de codificação de legendas aborda.
Antes de Partilhar o Ficheiro
- Execute o verificador e reveja cada legenda sinalizada.
- Encontre
',&e"e substitua-os. - Elimine linhas duplicadas em efeitos sonoros, números e música.
- Veja os minutos mais movimentados no leitor que os seus espectadores irão usar, no tamanho de ecrã que irão usar.
- Verifique se as linhas inferiores não tapam texto no ecrã do vídeo.
- Leia a tradução em contexto. O nosso fluxo de trabalho de legendas com IA explica como a rever.
Tem um SRT ou VTT pronto? Carregue-o no tradutor de legendas e veja o preço antes de pagar. Quando terminar, descarregue o ficheiro bilingue juntamente com o traduzido. Depois, execute o verificador, uma vez que a contagem de linhas num trabalho real depende de como o modelo divide cada legenda traduzida.
Publicações relacionadas