Cum să creezi subtitrări bilingve: două limbi într-un singur fișier SRT sau VTT
Creează un fișier SRT sau VTT bilingv pe care oamenii îl pot citi: îmbină după timp, încadrează două limbi într-un singur cue, alege care merge deasupra și rulează un verificator gratuit.
Pentru a crea subtitrări bilingve, ai nevoie de un fișier de subtitrări sincronizat, o traducere a acestuia care păstrează aceeași sincronizare și un cue pentru fiecare moment care să conțină ambele limbi: mai întâi liniile originale, apoi liniile traduse, sub un singur timestamp. Orice traducător care scrie un fișier dual face asta pentru tine, iar un instrument de îmbinare face același lucru dacă ai deja două fișiere. SRT simplu nu necesită o sintaxă specială pentru asta.
Crearea fișierului este partea ușoară. Partea mai dificilă este că sincronizarea a fost scrisă pentru o singură limbă. Un cue care încape două linii de engleză trebuie acum să conțină patru linii, în aceleași câteva secunde, peste aceeași imagine. Așa că acest ghid își petrece cea mai mare parte a timpului cu ce trebuie corectat după îmbinare.
Am scris un fișier de test cu 12 cue-uri, am produs versiuni în spaniolă, chineză și arabă și am scris un verificator gratuit. Fișierele provin din codul propriu de scriere a subtitrărilor al BookTranslator, rulat local. Am scris traducerile manual în loc să apelăm un model, așa că aceste teste arată ce se întâmplă cu fișierul, nu cât de bună este o traducere. README conține detaliile. Verificatorul necesită Python 3 și nimic altceva.
Răspuns rapid: Cum arată un cue bilingv
2
00:00:03,400 --> 00:00:06,600
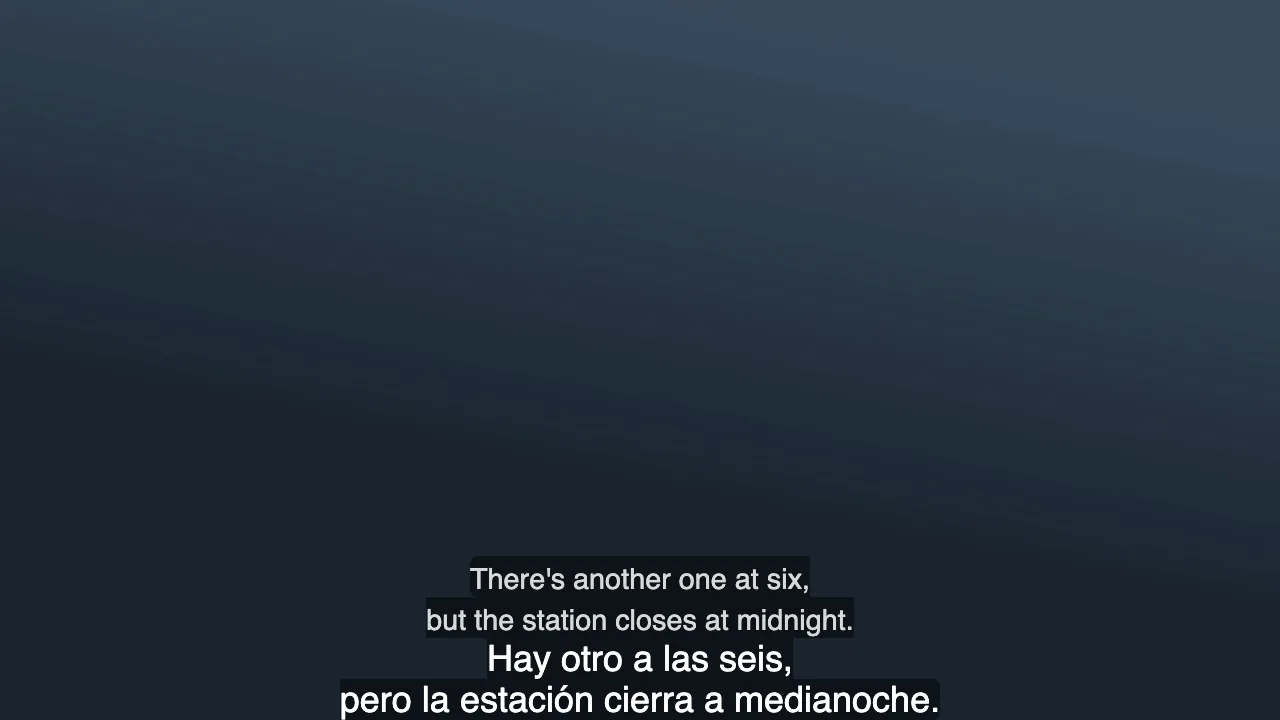
There's another one at six,
but the station closes at midnight.
Hay otro a las seis,
pero la estación cierra a medianoche.
Acesta este SRT valid. Fiecare cue își păstrează numărul și timestampul, iar fiecare linie de text de sub timestamp apare pe ecran împreună. WebVTT funcționează la fel.
Alege mai întâi configurația
| Vrei să | Folosește | De ce |
|---|---|---|
| Vizionezi în aproape orice player sau trimiți un singur fișier cuiva | Un singur SRT îmbinat | Este un fișier obișnuit de subtitrări, fără a fi nevoie de o funcție a playerului |
| Vizionezi pe propriul computer cu control asupra fiecărei limbi | Două fișiere separate într-un player cu suport pentru două piste | Fiecare limbă își păstrează sincronizarea și poate fi mutată sau dezactivată |
| Afișezi limbile la dimensiuni diferite pe o pagină web | Un singur VTT cu o clasă pentru fiecare limbă | WebVTT are stilizare; SRT nu are o modalitate standard de a face asta |
| Publici un videoclip care arată la fel peste tot | Subtitrări încorporate | Textul devine parte din imagine, iar spectatorii nu îl pot dezactiva |
Pentru două piste, mpv are o opțiune --secondary-sid. Manualul său spune că a doua pistă este desenată implicit în partea de sus a ecranului, ceea ce ține limbile separate. Nu am testat mpv noi înșine.
Pentru arderea în imagine, filtrul subtitles din FFmpeg are nevoie de o versiune compilată cu libass. Versiunea FFmpeg 9.0.1 pe care am instalat-o pentru acest test nu îl avea, așa că rulați ffmpeg -filters | grep subtitles înainte de a vă baza pe el. Nu am testat arderea în imagine.
Pasul 1: Puneți două limbi într-un singur fișier
Dacă aveți un singur fișier, traduceți-l cu un instrument care scrie un fișier dual. BookTranslator face acest lucru pentru fiecare sarcină SRT și VTT: primiți un fișier tradus și un fișier bilingv cu aceleași marcaje temporale și puteți începe de la traducătorul de subtitrări. Dacă trebuie să alegeți mai întâi un instrument, consultați comparația noastră de software pentru subtitrări.
Dacă aveți două fișiere, împerecheați-le după timp, nu după numărul replicii. Aici apar greșelile la fuzionare, deoarece două piste ale aceluiași videoclip rareori împart liniile la fel. A doua pistă spaniolă împarte două replici lungi în jumătate și omite efectul sonor, anul și muzica.
python3 check_bilingual_subs.py merge sample-source.srt sample-es-own-timing.srt -o merged.srt
Împerecherea după numărul replicii (opțiunea --index a scriptului) a greșit 10 din cele 12 replici, începând cu replica 2, unde jumătate din textul spaniol a lipsit. Până la replica 3, traducerea aparținea altei linii:
3
00:00:06,800 --> 00:00:08,000
So where do we wait?
pero la estación cierra a medianoche.
Împerecherea după timp a dat traducerea corectă pentru 9 replici, a lăsat neatinse cele 3 replici fără spaniolă și a raportat singura linie spaniolă care nu se potrivea cu nimic, astfel încât să o puteți plasa manual. Scriptul atribuie o replică din a doua pistă replicii din prima pistă cu care se suprapune cel mai mult, cu condiția ca aceasta să acopere cel puțin jumătate din lungimea ei. Instrumente precum submerger fuzionează de asemenea fișiere; nu le-am testat. Indiferent ce utilizați, verificați replicile după prima divizare.
Pasul 2: Verificați fișierul
python3 check_bilingual_subs.py check sample-source.srt sample-es-bilingual.srt --max-target-cps 17
Compară fișierul bilingv cu sursa și presupune că liniile originale vin primele, așa că rulați-l înainte de a inversa ordinea. Vă avertizează dacă liniile de sus nu corespund sursei. Iată ce a găsit în fișierul spaniol:
| Replică | Secunde | Linii | Caractere/secundă original | Caractere/secundă spaniolă | Problemă |
|---|---|---|---|---|---|
| 2 | 3.2 | 4 | 19.4 | 17.8 | Patru linii, spaniola prea rapidă |
| 5 | 2.7 | 2 | 6.7 | 7.0 | ' în text |
| 7 | 1.0 | 2 | 4.0 | 4.0 | Același text de două ori |
| 8 | 1.8 | 2 | 1.7 | 1.7 | Același text de două ori |
| 9 | 1.2 | 4 | 20.8 | 22.5 | Patru linii, ambele limbi prea rapide |
| 10 | 3.6 | 2 | 18.3 | 19.4 | Ambele linii peste 42 de caractere, spaniola prea rapidă |
Replicile 6 și 12 au revenit și ele cu patru linii. Celelalte patru replici au fost în regulă.
Limitele de viteză și lungime a liniilor provin de la Netflix, deoarece cifrele sale sunt publice și specifice și diferă în funcție de limbă. Ghidul său pentru engleză permite 42 de caractere pe linie, două linii și până la 20 de caractere pe secundă pentru programele pentru adulți. Ghidul său pentru spaniola latino-americană permite 17 caractere pe secundă pentru subtitrările traduse, iar ghidul său pentru chineza simplificată permite 16 caractere pe linie și 9 pe secundă. Așadar, folosiți --max-target-line 16 --max-target-cps 9 pentru chineză. Aceste ghiduri acoperă o singură limbă odată, cu cel mult două linii. Nu cunoaștem niciun standard echivalent pentru două limbi într-o singură replică, așa că valoarea implicită a verificatorului de trei linii pe ecran, precum și tot ce urmează în secțiunea următoare, reprezintă judecata noastră.
Verificatorul afișează și un număr combinat, care a ajuns la 43,3 caractere pe secundă la replica 9. Nu încercați să corectați acel număr. Nimeni nu citește fiecare caracter din ambele limbi cu atenție deplină. Tratați-l ca pe un indicator către replicile care merită urmărite.
Pasul 3: Corectați replicile cu patru linii
Iată cât costă patru rânduri. În afișarea implicită a subtitrărilor din Chromium la 1280x720, replica engleză pe două rânduri ocupa 10,6% din înălțimea cadrului, iar aceeași replică cu spaniolă adăugată ocupa 21,9%.
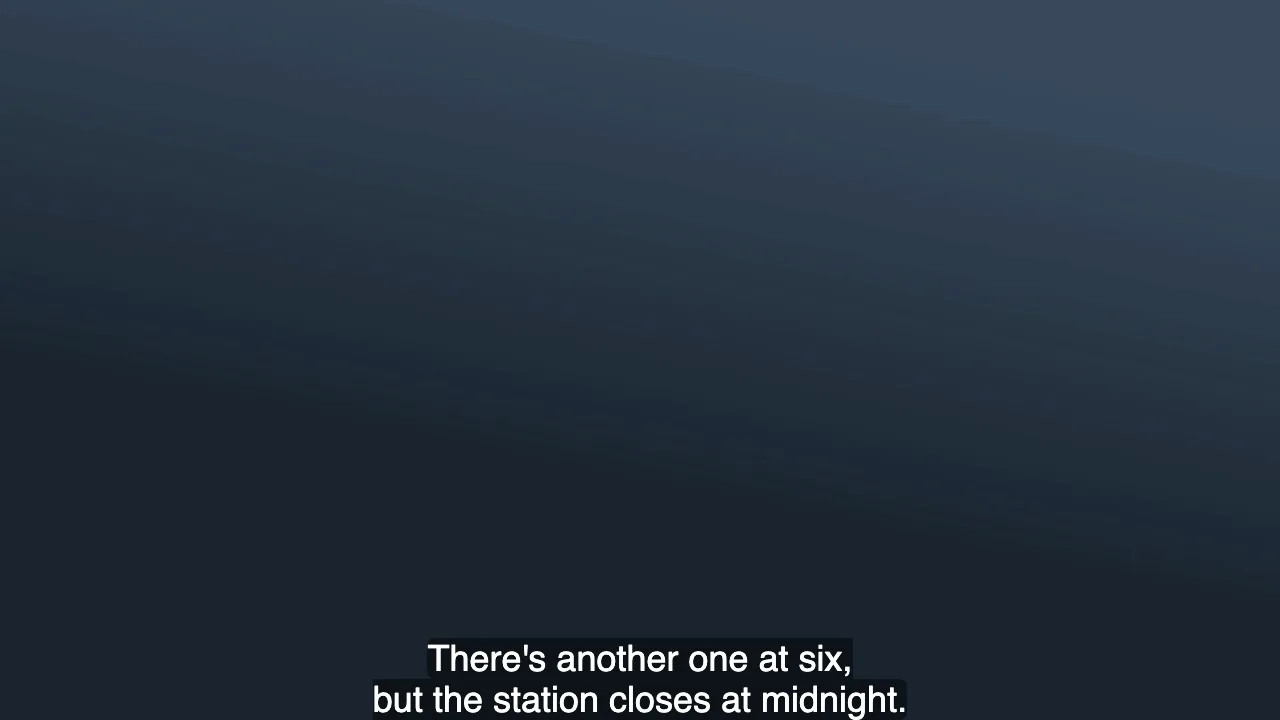
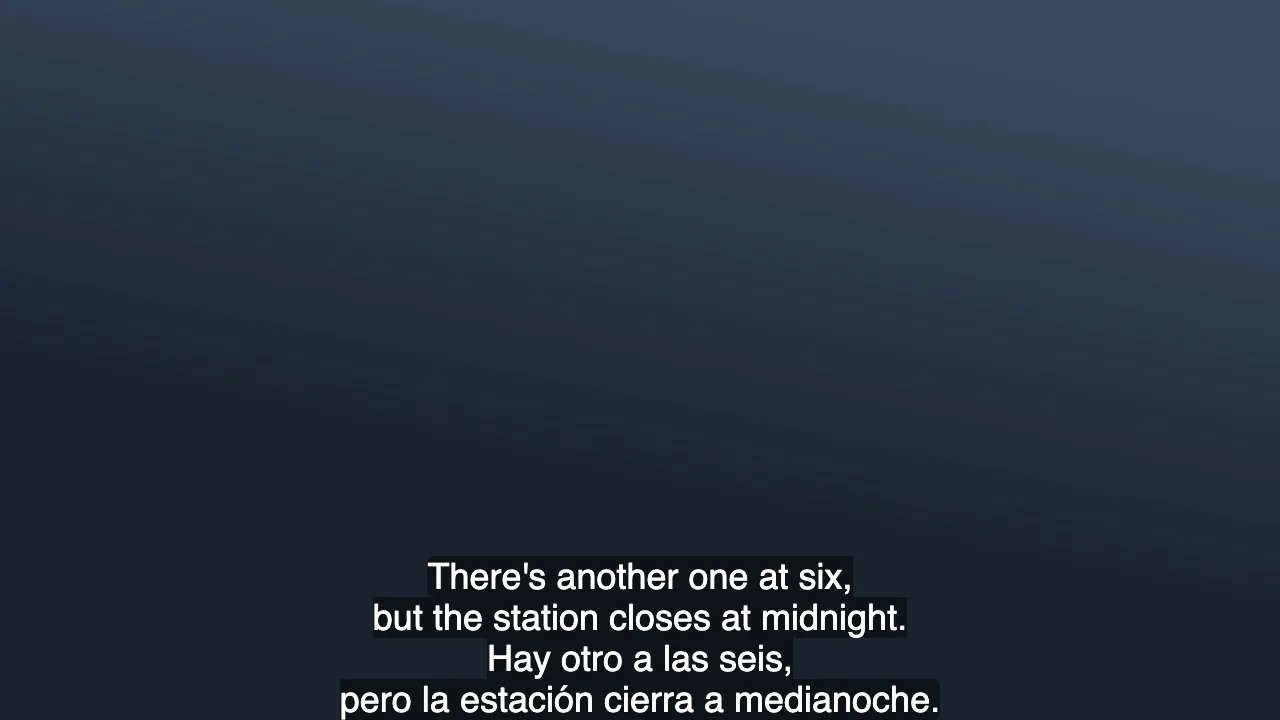
Parcurgeți replicile semnalate în această ordine:
- Păstrați limba audio cuvânt cu cuvânt. Dacă oamenii ascultă originalul și urmăresc textul, un original scurtat nu mai corespunde cu ce aud.
- Reduceți cealaltă limbă la un singur rând. Replica noastră 2 trece de la 17,8 caractere pe secundă la 13,1 când spaniola devine
A las seis hay otro; cierran a medianoche.Asta înseamnă trei rânduri pe ecran în loc de patru și păstrează ambele informații. - Adăugați timp doar dacă există un interval. Verificați începutul replicii următoare înainte de a muta un sfârșit. Replica 2 are 0,2 secunde disponibile, ceea ce nu merită efortul.
- Apoi lăsați restul în pace. Replica 9 este
You knew?/Since March.în 1,2 secunde. Încalcă limitele de viteză și de rânduri, dar am lăsa-o: intervalul de 0,2 secunde de după ea este prea mic pentru a ajuta, iar un spectator poate probabil să cuprindă două replici scurte dintr-o privire. Nu fiecare semnalare este o eroare.
Pentru rânduri lungi singulare precum replica 10, împărțiți fiecare limbă în două rânduri doar dacă replica are timpul necesar. Altfel, scurtați traducerea.
Dacă controlați afișarea, puteți face și o limbă mai ușor de distins. Rulați to-vtt pentru a da fiecărei limbi propria clasă. Fișierul rezultat redat în Chromium cu engleza la 80% dimensiune și în gri deschis. Asta economisește abia spațiu (21,1% din înălțimea cadrului în loc de 21,9%), deci nu înlocuiește tăierea unui rând. Nu am testat dacă ajută oamenii să citească.
Aceasta folosește clasele de replică WebVTT și selectorul ::cue(). Este destinată browserelor. Alți playere pot ignora stilurile sau fișierul VTT.
Pasul 4: Decideți ce limbă merge deasupra
Există niște cercetări pe acest subiect. Într-un studiu de eye-tracking din 2026 cu 42 de vorbitori nativi de spaniolă cu engleza ca a doua limbă, spectatorii au petrecut mai mult timp pe rândul de sus, indiferent de limbă, și mai mult timp pe rândul care corespundea sunetului. Scorurile de înțelegere au fost mai mari cu spaniola, limba lor maternă, deasupra. Un studiu anterior cu 112 învățăcei chinezi de engleză a constatat că subtitrările bilingve au ajutat la înțelegere la fel de mult ca subtitrările doar în limba lor maternă, iar ambele au depășit subtitrările în engleză sau lipsa subtitrărilor.
Acestea sunt studii singulare pe grupuri specifice de spectatori, așa că luați-le ca punct de plecare:
- Urmărirea unui film sau a unei prelegeri pentru conținut: puneți deasupra limba pe care o citiți cel mai bine.
- Exersarea unei limbi pe care o învățați: puneți acea limbă deasupra și acceptați că s-ar putea să înțelegeți ceva mai puțin. Înțelegerea este ceea ce a măsurat studiul din 2026, nu învățarea, așa că aceasta este judecata noastră.
- Revizuirea unei traduceri: ordinea contează puțin, așa că lăsați-o așa.
Fișierul bilingv al BookTranslator pune întotdeauna originalul deasupra. Pentru a inversa:
python3 check_bilingual_subs.py flip sample-source.srt sample-es-bilingual.srt -o translation-on-top.srt
Ce iese greșit și cum se remediază
Acestea provin din rularea codului de subtitrări al BookTranslator pe fișierele noastre de test, iar verificatorul semnalează primele două.
- Textul care nu necesită traducere apare de două ori.
1984și♪ ♪sunt omise ca neavând cuvinte de tradus, așa că fișierul bilingv le tipărește pe fiecare de două ori. Ștergeți un rând manual. 'poate apărea în text. Din noiembrie 2026, o replică cu etichete de formatare și un apostrof poate reveni cu apostroful escapat. Rândul nostru original a devenit<i>Don't answer that.</i>în fișierul bilingv, iar într-un test VTT separat o traducere în franceză a devenit<i>Je n'attendrai pas.</i>și în fișierul tradus. Chromium l-a decodat în VTT și a afișat un apostrof normal. Dar când am convertit SRT-ul cu FFmpeg,'a rămas în textul de ieșire, așa că presupuneți că unele playere îl vor afișa literal. Înlocuiți'cu'înainte de a folosi fișierul. Am raportat acest lucru inginerilor noștri.- Setările de replică VTT sunt eliminate. Setările de poziție precum
line:0 align:start position:10%și blocurileNOTEau dispărut din ieșirea noastră de test VTT, iar etichetele vorbitorului au apărut pe ambele rânduri. Dacă VTT-ul dvs. se bazează pe plasare, adăugați-o înapoi după traducere. - Textul de la dreapta la stânga este marcat linie cu linie. Liniile în arabă au revenit încadrate în marcaje Unicode de direcție. Am analizat un singur cue, într-o copie VTT a fișierului în Chromium, și acesta s-a afișat de la dreapta la stânga. Liniile care combină araba cu cifre, precum cue-ul nostru 10, sunt cazul mai dificil și nu le-am vizualizat, așa că testați în playerul dumneavoastră real. SRT nu are altă modalitate de a seta direcția. Ghidul nostru pentru dreapta-la-stânga acoperă problemele mai ample pentru cărți.
Dacă sursa dumneavoastră este ASS sau SSA, rezultatul bilingv al BookTranslator adaugă linia tradusă ca un al doilea eveniment cu același stil și aceeași sincronizare, ceea ce reprezintă o structură diferită. Ghidul nostru pentru subtitrări ASS explică modul în care sunt construite aceste fișiere. Dacă caracterele accentuate par defecte în oricare dintre limbi, problema este de obicei codificarea fișierului, pe care o acoperă ghidul nostru pentru codificarea subtitrărilor.
Înainte de a partaja fișierul
- Rulați verificatorul și parcurgeți fiecare cue semnalat.
- Găsiți
',&și"și înlocuiți-le. - Ștergeți liniile duplicate pentru efecte sonore, numere și muzică.
- Urmăriți cele mai aglomerate câteva minute în playerul pe care îl vor folosi spectatorii, pe dimensiunea de ecran pe care o vor folosi.
- Verificați ca liniile de jos să nu acopere textul de pe ecran din videoclip.
- Citiți traducerea în context. Fluxul nostru de lucru pentru subtitrări AI acoperă modul de revizuire.
Aveți un SRT sau VTT pregătit? Încărcați-l la traducătorul de subtitrări și vedeți prețul înainte de a plăti. Când se termină, descărcați fișierul bilingv împreună cu cel tradus. Apoi rulați verificatorul pe el, deoarece numărul de linii într-o sarcină reală depinde de modul în care modelul împarte fiecare cue tradus.
Articole asociate