如何在翻譯 PDF 時保留原始格式
使用可重現的 PDF 工作流程,在翻譯過程中保留閱讀順序、表格、圖表、字型、由右至左文字與頁面版面配置。

快速解答:保留文件有意義的結構,而非每一個座標
若要翻譯 PDF 而不遺失格式,請先判斷其中包含的是可選取的文字、掃描影像,還是兩者兼具。接著,在處理整份檔案之前,先以版面感知的 PDF 翻譯工具 測試最具挑戰性的代表性頁面。分別檢查閱讀順序、文字溢出、表格、圖表標籤、註腳、字型,以及由右至左的文字。
目標並非逐像素完全一致。翻譯可能移動換行位置或增加頁面,卻仍正確保留文件內容。當資訊消失、被移到錯誤的表格列、變得無法閱讀,或失去與圖說、註腳或視覺元素的關聯時,才算失敗。
請以下方決策表作為起點:
| 你手邊的 PDF | 第一步動作 | 主要格式風險 |
|---|---|---|
| 可選取的數位 PDF | 直接翻譯其中一頁困難頁面 | 閱讀順序與文字框溢出 |
| 掃描或拍攝的 PDF | 執行 OCR、檢查文字層,然後翻譯 | OCR 錯誤變成翻譯錯誤 |
| 含密集表格或圖表的 PDF | 測試含有合併儲存格、數字與標籤的頁面 | 版面看似正確,但資料關聯錯誤 |
| 雙欄論文或報告 | 在評斷流暢度之前,先檢查擷取結果與閱讀順序 | 欄位合併或段落翻譯順序錯亂 |
| 表單、證書或固定範本 | 判斷哪些座標與頁面參照在法律或作業上屬於固定不變 | 因文字區域僵化而遭裁切 |
| 雙語對照審閱版 | 可選擇並排、交錯、對頁或同步檔案 | 欄位過窄與原文譯文對齊不穩定 |
這是 PDF 翻譯分類 的核心工作流程。如果你是在比較產品而非診斷檔案,請先閱讀 PDF 翻譯工具比較。如果你無法選取任何文字,請直接前往 掃描 PDF 與 OCR 工作流程。
「保留格式」實際上應該代表什麼
格式保留不是單一的通過或失敗功能。它至少包含五個層面:
- 內容完整性: 每個有意義的段落、標籤、警告、數字和註記都仍然存在。
- 邏輯結構: 標題、清單、表格儲存格、圖說、註腳和閱讀順序仍然表達相同的關係。
- 視覺階層: 標題看起來仍像標題,圖說仍處於從屬地位,相關物件仍保持群組。
- 文字系統支援: 所選字型包含目標字符,且方向和標點能正確呈現。
- 頁面可用性: 結果在正常大小下仍可閱讀,沒有裁切、重疊或任意縮小字型。
Adobe 的 PDF 文件將可見頁面內容描述為一連串物件和標記操作,而不是像 Word 那樣可編輯的段落序列。它也區分了文件的邏輯結構與視覺位置。這個區別說明了為什麼 PDF 看起來正確,但複製的文字、無障礙順序或翻譯順序卻是錯的。請參閱 Adobe 關於 PDF 頁面內容 和 標記 PDF 中的邏輯結構 的文件。
實用規則很簡單:在關係層面比較翻譯後的文件,而不只是比較螢幕截圖。
可重現的 PDF 版面壓力測試
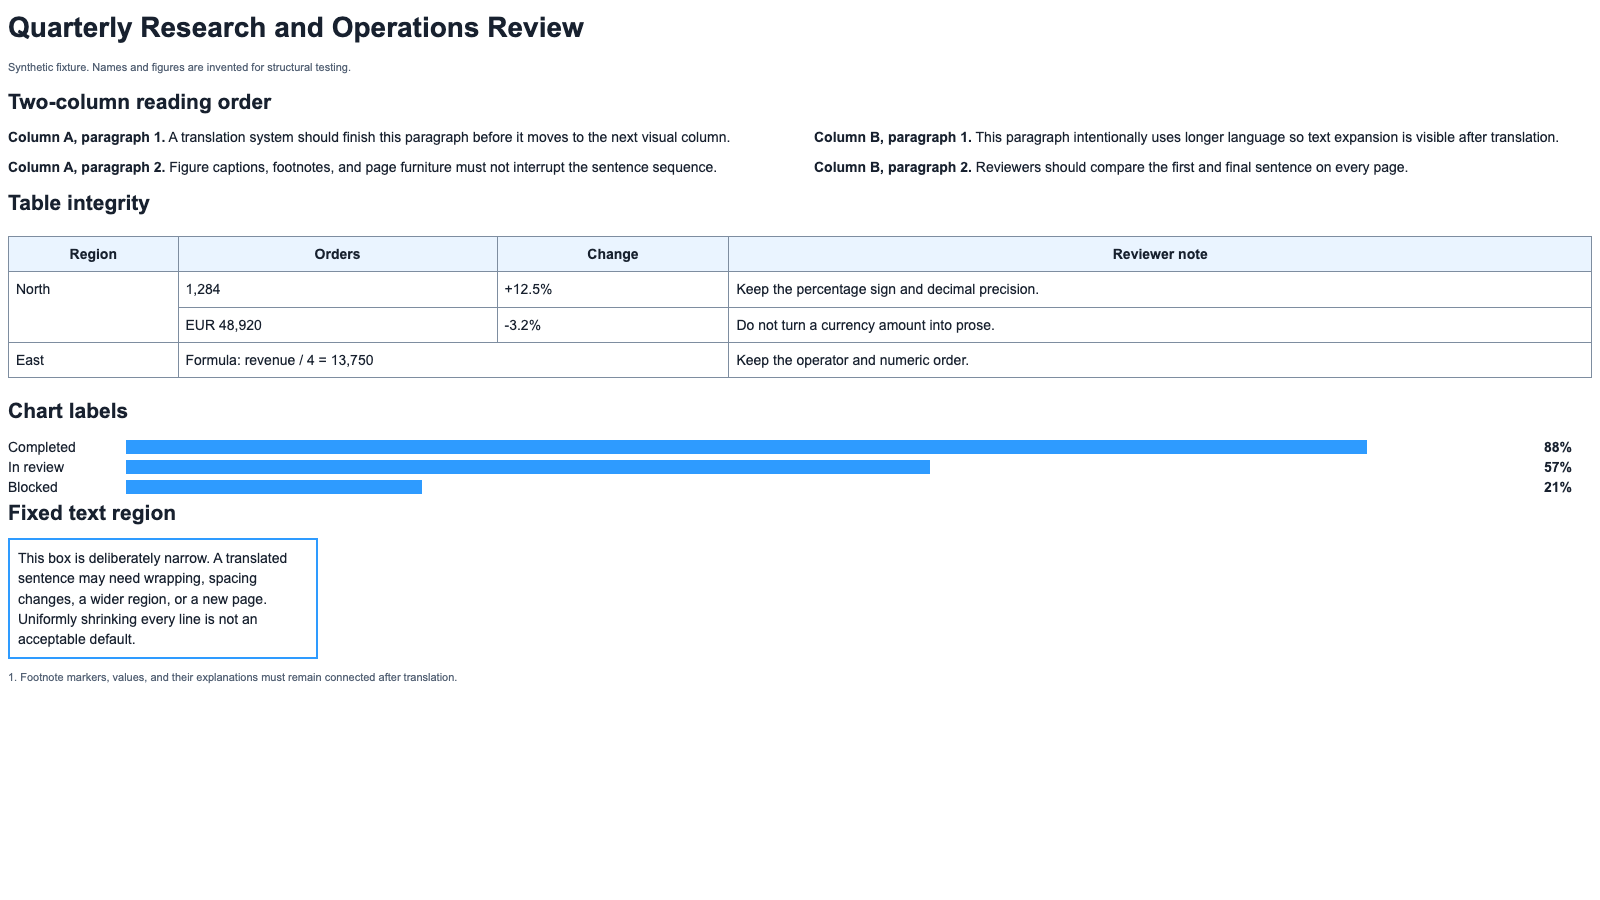
我們建立了一份兩頁的合成 PDF 版面翻譯壓力測試,以便在不使用客戶文件的情況下測試 PDF 的困難部分。這是一份 A4、已標記的 PDF,包含虛構的名稱和數字。它是一個測試樣本,不是供應商基準,也不能證明任何工具能產生準確的翻譯。
第 1 頁測試:
- 雙欄閱讀順序;
- 含有合併儲存格的表格;
- 整數、貨幣金額、帶正負號的百分比和公式;
- 位置帶有意義的圖表標籤;
- 刻意狹窄的固定文字區域;
- 必須與其標記保持連接的註腳。
第 2 頁將英文、德文、中文和阿拉伯文文字放入相同大小的方框中。它揭示了四個不同的問題:局部擴張、換行、缺少字符和雙向版面。
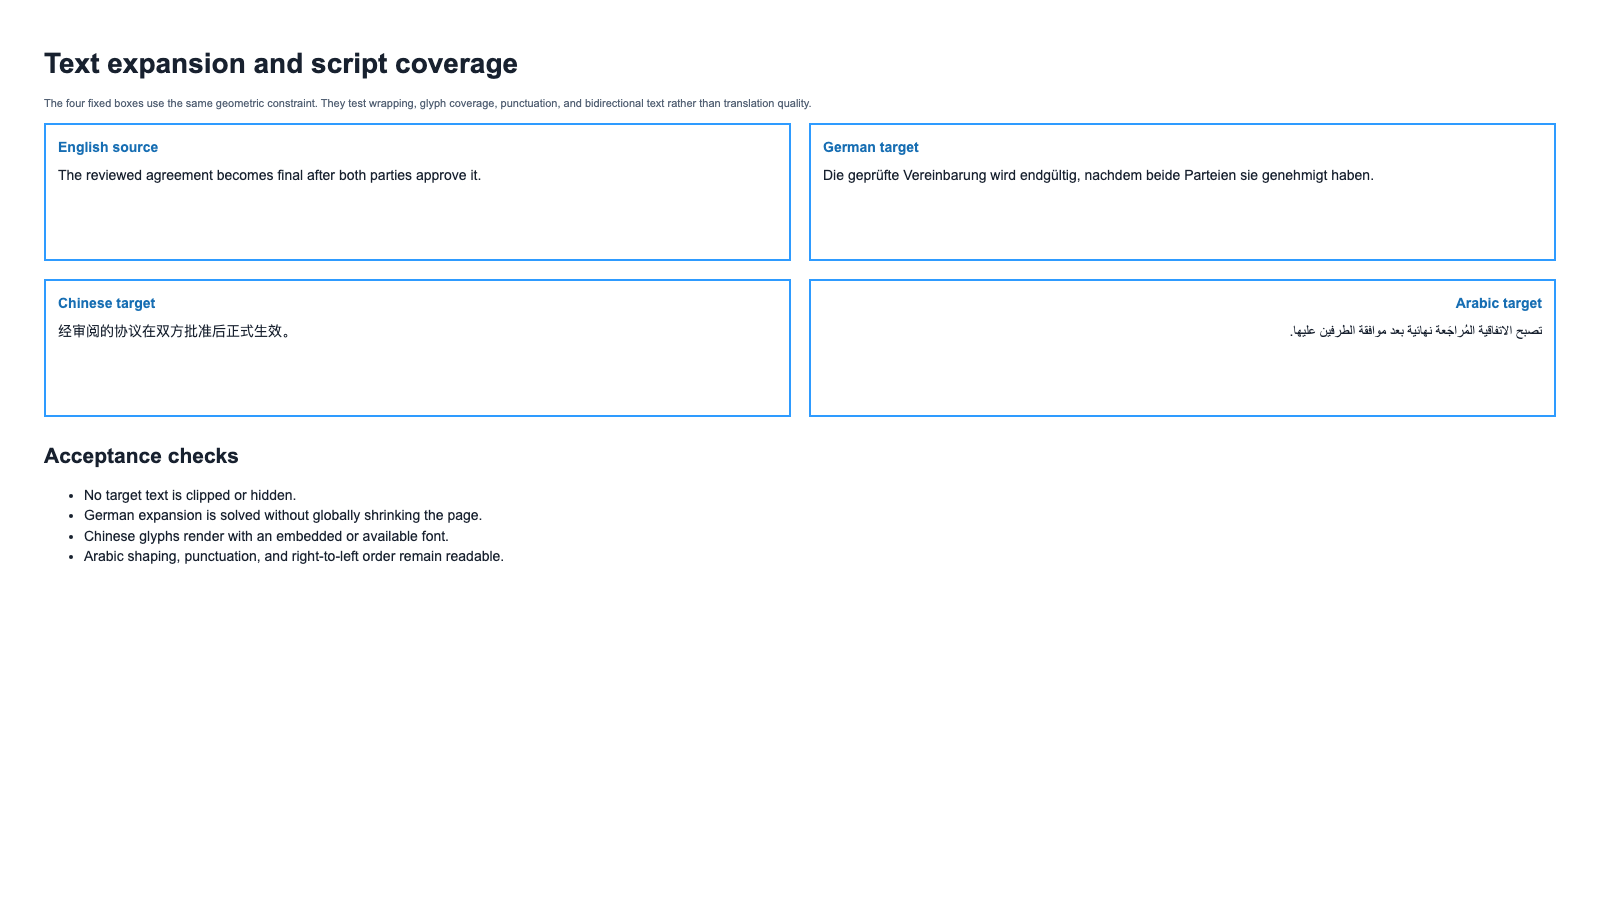
W3C 關於翻譯中的文字大小的指引說明了為何簡短標籤和空間侷促的區域可能出現不成比例的擴張,而其他譯文則可能縮短。Unicode 的雙向演算法則規範了混合由左至右與由右至左字元的解析方式。這兩個問題都無法單靠計算原文的字元數來可靠解決。
下載這個測試樣本,並用你正在考慮的任何工作流程跑一遍。記錄工具、日期、設定、來源語言、目標語言和輸出檔案。這樣就能把「格式看起來還可以」變成可重複驗證的測試。
翻譯前先診斷你的 PDF
1. 測試文字是否可選取
試著選取一個句子和一個表格儲存格。
- 如果兩者都能乾淨選取,這個 PDF 大概有可用的文字層。
- 如果整頁選取起來是一張圖片,就需要 OCR。
- 如果文字只能以細碎片段選取,或複製出來的行次序錯亂,代表視覺位置不等於邏輯結構。
Adobe 指出,掃描的 PDF 一開始只包含影像資料,而非可搜尋的文字。OCR 會加入可選取、可搜尋的文字層,但 Adobe 也建議在處理後檢查辨識錯誤。請參閱辨識掃描 PDF 中的文字。
2. 將困難的段落複製到純文字編輯器
請用雙欄段落、一整行表格列,以及圖說來測試。如果貼上的順序在翻譯前就已經錯誤,翻譯層就是從錯誤的順序開始處理。
Adobe 的閱讀順序工具說明文件顯示,複雜表格、圖形、間距緊密的欄位,以及頁面元素,可能需要明確修復順序與標籤。流暢度無法修復一個由錯誤片段拼湊而成的段落。
3. 選擇最具代表性的最難頁面
不要測試標題頁。選擇最可能失敗的頁面:
- 最密集的表格;
- 最狹窄的側邊欄或提示框;
- 帶有註腳的雙欄頁面;
- 標籤簡短的圖表;
- 包含中日韓文字、阿拉伯文、天城文或混合書寫系統的頁面;
- 對比度低或歪斜的掃描頁。
如果最難的頁面失敗了,先翻譯 200 頁較簡單的內容只會製造更多後續清理工作。
4. 記錄不可妥協的限制條件
不同文件對「保留格式」有不同的定義。
| 文件類型 | 通常不可妥協 | 通常可彈性調整 |
|---|---|---|
| 合約或表單 | 條款完整性、標籤、簽名、頁面參照 | 區域換行與小幅間距調整 |
| 學術論文 | 方程式、引用、圖表關聯、閱讀順序 | 頁數與段落換行 |
| 年度報告 | 數字、單位、表格列、圖表關聯 | 標籤換行與局部區域大小 |
| 操作手冊 | 警告、步驟順序、提示框、圖片參照 | 分頁與受控重排 |
| 書籍或長篇報告 | 章節順序、標題、註釋、圖片位置 | 頁數與段落流動 |
在選擇修復方式之前,先把這些限制寫下來。否則審閱者往往會為了保護視覺相似度,而犧牲了意義。
最安全的端到端工作流程
步驟 1:保留原始檔並建立基準
保留一份未經修改的原始檔。記錄頁數、檔案類型、語言、PDF 是否已加上標籤,以及文字是否可選取。如果文件日後會更新,請同時保留原始來源文件和 PDF。
步驟 2:僅在必要時執行 OCR
對於純圖片頁面,請以正確的來源語言執行 OCR。在翻譯之前,先檢查姓名、數字、標點、表格、註腳和低對比度區域。OCR 錯誤是上游錯誤:翻譯系統可能會根據辨識錯誤的文字,產出流暢的譯文。
專門的掃描 PDF 指南更詳細地說明了掃描清理、OCR 語言選擇、可疑字元以及隱私檢查。
步驟 3:翻譯代表性頁面
使用專為回傳文件(而不只是翻譯後的文字)所設計的工作流程。對大多數保留格式的 PDF 而言,這表示將測試檔案上傳至 BookTranslator PDF 翻譯工具、選擇語言組合,然後檢閱回傳的 PDF。
不要只評估最簡單的段落。請比對基準中所列出的確切元素。
步驟 4:先檢閱結構,再檢閱措辭
請依此順序檢查:
- 是否包含了所有來源區域?
- 閱讀順序是否正確?
- 表格列、圖表標籤、圖說和註腳是否仍指向正確的物件?
- 數字、名稱、單位和公式是否完好無損?
- 目標文字系統是否正確呈現?
- 然後才問:翻譯是否流暢且準確?
文字順序錯誤,即使翻譯再精美,仍是失敗的文件。
步驟 5:翻譯完整檔案並抽樣檢查高風險頁面
代表性頁面通過後,翻譯完整的 PDF。請檢閱每種高風險結構首次、中間和最後出現的位置,而不是只檢查第一頁。
對長篇報告而言,這可能表示:
- 第一頁和最後一頁雙欄頁面;
- 最簡單和最密集的表格;
- 開頭和結尾附近的圖表;
- 每一頁警告頁面;
- 每一頁目標文字系統或字型有變更的頁面。
步驟 6:採用破壞性最小的修復方式
局部問題就局部修復。不要因為一個標題太長就全域縮小整份文件。
在不縮小所有內容的情況下修正文字溢出
當目標語言的措辭不再符合原文區域的幾何配置時,譯文就會溢出。直接原因可能是文字膨脹,但真正的限制通常來自某個特定的文字框、欄、列、字型或斷行規則。
請依下列順序進行修復:
| 順序 | 修復方式 | 適用時機 | 主要風險 |
|---|---|---|---|
| 1 | 允許自然換行 | 該區域還有未使用的垂直空間 | 清單縮排或列高可能會改變 |
| 2 | 調整局部行距或段落間距 | 溢出範圍很小 | 文字過於密集可能變得較難閱讀 |
| 3 | 加寬或擴大受影響的區域 | 鄰近的空白確實未被使用 | 相鄰物件可能會移動 |
| 4 | 重新排版鄰近元素 | 有多個區塊在爭奪空間 | 頁面層級與參照可能會偏移 |
| 5 | 採用經核准的較短目標術語 | 存在標準的簡潔術語 | 語意需要雙語審閱 |
| 6 | 新增續接頁面 | 內容無法以清晰易讀的方式容納 | 分頁會改變 |
| 7 | 局部縮小字級 | 小幅縮小仍可維持可讀性 | 無障礙性與視覺一致性 |
不要依賴單一的語言擴張百分比。德文段落可能放得下,但複合標題卻會失敗。中文行文可能縮短,但未翻譯的網址仍會超出儲存格。阿拉伯文可能以字元數計算放得下,卻因為字型、字形組合、標點或方向錯誤而失敗。
請使用以下診斷方式:
- 在單一區塊中被裁切: 調整該區域的大小或重新排版。
- 出現方框或字元缺失: 替換或嵌入含有所需字符的字型。
- 長字詞或網址不換行: 修正斷行或連字規則。
- 只有表格標題失敗: 使用針對表格的修復方式。
- 重複的頁首在每一頁都發生碰撞: 修改頁面範本,而非逐一修改每個段落。
- 兩個片段合併成一個過大的段落: 先修復閱讀順序,再處理排版。
如果來源版面沒有空間容納忠實的目標語言版本,那麼要求座標完全相同就是錯誤的驗收標準。應改為保留完整性、階層結構與可讀性。
保留表格、圖表、數字與註腳
PDF 表格不一定以表格形式儲存。它可能是格線上的可編輯文字、許多定位片段,或單一圖片。圖表標籤可能是獨立文字,或已內嵌於圖形中。
這會產生四種獨立的失敗類別:
| 失敗類別 | 範例 | 為何僅靠視覺檢查會遺漏 |
|---|---|---|
| 結構性 | 合併儲存格被拆分,或兩個儲存格變成一個句子 | 結果可能看起來仍對齊 |
| 數值性 | -3.2% 遺失負號或移到另一列 | 流暢的行文會分散對數值的注意力 |
| 視覺 | 翻譯後的頁眉跨越了邊界 | 文字可能仍然完整 |
| 指涉 | 腳註標記失去了它的註釋 | 這兩個部分可能仍出現在其他地方 |
對以下項目使用受保護權杖審查:
- 整數與小數值;
- 正負號;
- 百分比、貨幣、日期與版本號碼;
- 單位與公式;
- 表格與圖表編號;
- 腳註標記及其限定文字。
地區慣例可能會改變小數分隔符或貨幣位置。問題不在於每個字元是否完全相同,而在於目標語言是否代表相同的數量,並保持與正確標籤的連結。
針對每個表格,請驗證:
- 列數與欄數仍然相符。
- 合併儲存格涵蓋相同的記錄。
- 每個數字仍與其來源標籤配對。
- 單位、正負號與精確度皆正確。
- 腳註仍限定預期的數值。
- 頁眉換行未隱藏內容。
針對每個圖表,請驗證幾何形狀與資料保持不變、標籤仍能識別正確的視覺標記,且圖說仍保持連結。若標籤已內嵌於圖像中,請使用具圖像感知能力的 OCR 並重新繪製,或保留原始圖表並加上翻譯後的圖說或圖例。請勿為了容納較長的標籤而拉伸或裁切圖表。
如果財務、科學或法律表格中即使只有一個錯誤的數值關係,無論文件看起來多麼精美,它都是失敗的。
選擇雙語 PDF 版面配置
當有人必須對照原文來驗證譯文時,雙語 PDF 就很有用。但它未必自動就是最佳的成品交付格式。
| 審閱任務 | 最適合的起始版面 | 取捨 |
|---|---|---|
| 逐段編輯 | 原文在左,譯文在右 | 窄欄會放大溢排問題 |
| 手機或平板閱讀 | 原文段落後接譯文段落 | 頁數會增加 |
| 法律或檔案參考 | 原文與譯文對頁並排 | 文件長度大約會變成兩倍 |
| 密集表格與固定版面 | 各自獨立但同步的原文與譯文 PDF | 需要能讓頁面保持對齊的檢視器或審閱流程 |
| 交付客戶 | 純譯文 PDF,外加一份獨立的雙語審閱版 | 必須維護兩份受控檔案 |
不要以視覺上的換行位置來對齊。翻譯可能把一個原文句子拆成兩個譯文句子,或把兩個短句合併。請以標題、段落順序、表格編號、圖表編號、清單項目和註腳標記作為穩定的錨點。
當原文本身已有多欄、密集表格、邊註或明顯的局部擴增時,並排對照並不是理想的預設做法。在這些情況下,對頁並排或同步的單語檔案更能維持正常的閱讀寬度,也更容易找出問題所在。
情況允許時,兩種語言都應保持可搜尋、可選取。請檢查複製文字的顺序、文件語言中繼資料、標題、表格標籤和圖表描述。如果無障礙性是硬性要求,獨立的單語檔案通常比複雜的交替欄結構更安全。
選擇合適的工具
專用 PDF 翻譯工具
對於篇幅長、格式複雜或需交付客戶的 PDF,請使用專門的翻譯工具。當你需要的產出是另一份可用的 PDF,而非純文字轉錄時,這才是正確的起點。
Google 翻譯
若只是為了快速理解簡短、簡單的文件,且版面配置並非交付重點,可使用 Google 翻譯。多欄頁面、掃描檔、密集表格以及最終出版品,則需要更受控的工作流程。Google 翻譯 PDF 指南涵蓋了其文件處理流程與失敗徵兆。
ChatGPT
ChatGPT 適合用於簡短段落、詞彙表準備、語氣判斷以及雙語審閱。請勿將聊天介面當作長篇 PDF 的頁面版面引擎。ChatGPT PDF 工作流程包含了禁止摘要與新增內容的提示詞。
將 PDF 轉換為 DOCX
唯有在你打算手動編輯或重建文件時,才需要先進行轉換。轉換可能在翻譯開始前就拆散表格、重排片段,並將圖表標籤變成浮動文字方塊。請先測試最困難的頁面再決定是否採用。若轉換後的 DOCX 結構乾淨,可繼續使用 DOCX 翻譯工具;若轉換後已經損壞,翻譯也無法修復轉換造成的問題。
人工或雙語審閱者
法律、醫療、金融、安全關鍵、學術或出版內容,請交由合格的審閱者處理。版面工作流程可以保留每一個區塊,但語意仍可能出錯。可參考真實翻譯範例,了解我們如何將語言審閱與版面審閱分開進行。
PDF 翻譯驗收檢查清單
阻礙性問題
- 文字遺漏或被裁切
- 閱讀順序錯誤
- 段落或標籤重疊
- 數字被分配到錯誤的列或圖表元素
- 公式、符號、單位或參照遭到變更
- 字級過小無法閱讀
- 缺少目標語言字符
- 阿拉伯文或希伯來文的方向與標點錯誤
- 警告、圖說或註腳被隱藏
重大缺陷
- 換行不順但可讀
- 圖說與圖表分離
- 頁面出現大幅無法解釋的位移
- 標題處理方式不一致
- 局部字型大小反覆變更
- 雙語區塊對應到錯誤的原文段落
外觀上的差異
- 不同的換行符號
- 小幅的空白變更
- 頁數略有變動,但參考文獻已修正
- 表格列高略有不同,但所有內容皆完整顯示
針對每個失敗的頁面,記錄原文頁面、元素類型、症狀、綁定限制、修復方式,以及是否需要進行雙語意義審查。這樣的稽核軌跡比只說「已調整格式」更有用。
適用於大多數 PDF 的建議工作流程
- 保留一份未經修改的原始 PDF。
- 檢查文字與表格儲存格是否可選取。
- 僅針對純圖片內容執行 OCR,然後檢查辨識錯誤。
- 下載 PDF 壓力測試,或從你自己的檔案中挑選最困難的一頁。
- 使用 PDF Translator 翻譯那個具代表性的頁面。
- 在評估語言流暢度之前,先檢查閱讀順序、表格、數字、標籤、註腳、字型與文字方向。
- 只有在具代表性的頁面通過檢查後,才翻譯完整檔案。
- 在局部修復局部限制;不要全域縮小整份文件。
- 將原文、翻譯後的 PDF、設定、詞彙表與審查筆記保存在一起,以供日後修訂使用。
若涉及方程式、引用與研究版面,請繼續使用學術論文翻譯工作流程。如果你還在決定原文該用 PDF 還是 EPUB,請參考 EPUB 與 PDF 選擇指南。